# 安装必要的包
if (!requireNamespace("qqman", quietly = TRUE)) {
  install.packages("qqman")
}

# 加载包
library(ggplot2)
library(dplyr)
library(qqman)Q-Q 图
分位数-分位数图(Q-Q 图)把样本的分位数与某个理论分布的分位数(或第二个样本的分位数)两两配对作图。若分布形状一致,点落在一条直线上;偏离方式即可诊断失配——S 形意味着偏态、U 形意味着厚尾、截距平移意味着位置不同。它是模型残差正态性诊断中信息量最大的一张图,而全基因组关联研究(GWAS)版本——观测与期望的 −log₁₀(p)——是关联研究校准的标准检查 [1]。
本教程涵盖四种工作流:
- 偏态样本的基础正态 Q-Q 图(
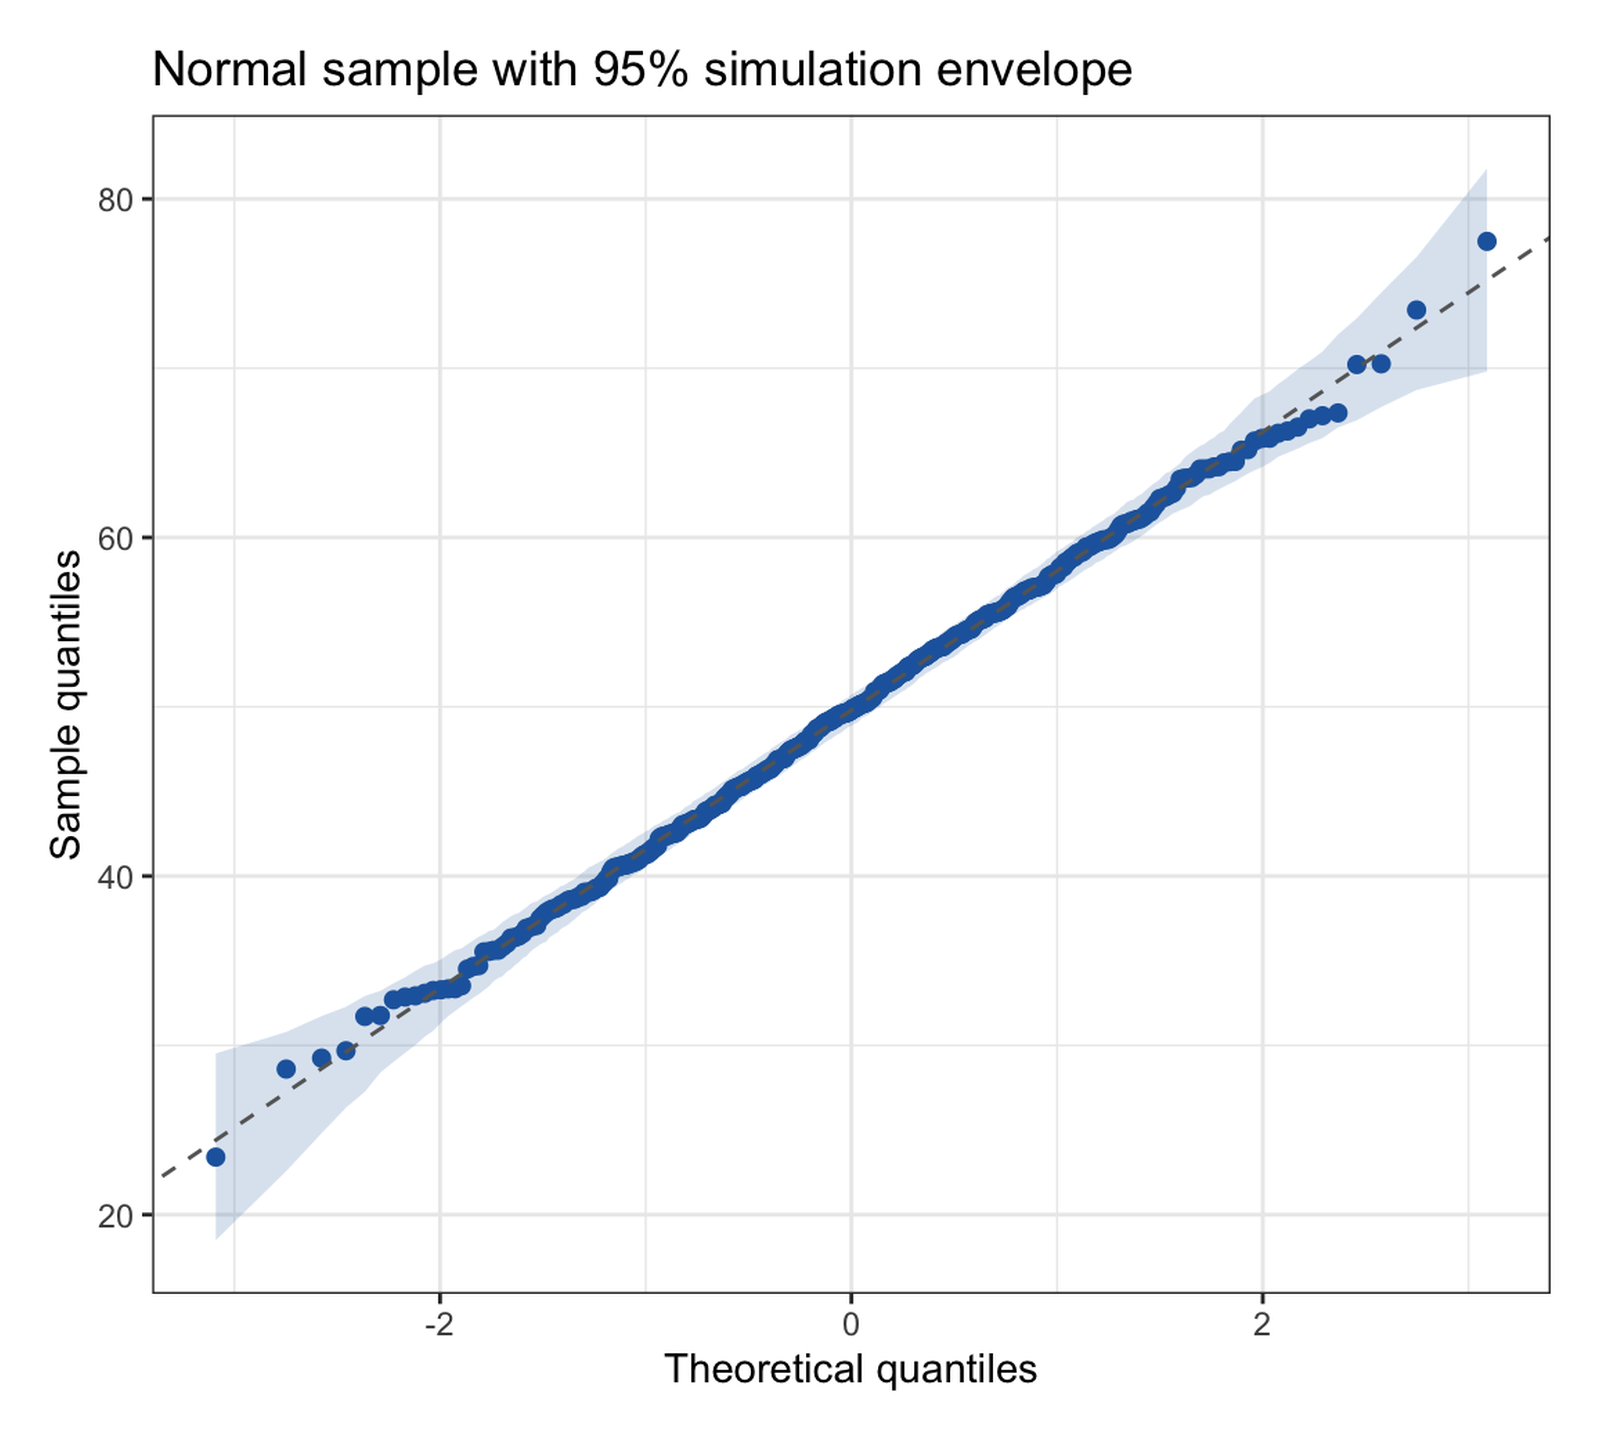
qqnorm/stat_qq); - 带 95% 模拟包络的 Q-Q 图(“这个偏离是否真实”的诚实版本);
- 比较两个经验分布的两样本 Q-Q 图;
- 带基因组膨胀因子 λ 的 GWAS p 值 Q-Q 图(qqman)[2]。
Example
Setup
系统要求:跨平台(Linux/MacOS/Windows)
编程语言:R
依赖包:
ggplot2;dplyr;qqman
sessioninfo::session_info("attached")─ Session info ───────────────────────────────────────────────────────────────
setting value
version R version 4.6.2 (2026-10-29)
os Ubuntu 24.04.5 LTS
system x86_64, linux-gnu
ui X11
language (EN)
collate C.UTF-8
ctype C.UTF-8
tz UTC
date 2026-10-31
pandoc 3.1.3 @ /usr/bin/ (via rmarkdown)
quarto 1.10.20 @ /usr/local/bin/quarto
─ Packages ───────────────────────────────────────────────────────────────────
! package * version date (UTC) lib source
P dplyr * 1.2.1 2026-04-03 [?] RSPM
P ggplot2 * 4.0.3.9000 2026-10-30 [?] Github (tidyverse/ggplot2@b638d65)
P qqman * 0.1.9 2023-08-23 [?] RSPM
[1] /home/runner/.cache/R/renv/library/Bizard-5140bdc6/linux-ubuntu-noble/R-4.6/x86_64-pc-linux-gnu
[2] /home/runner/work/_temp/Library
[3] /opt/R/4.6.2/lib/R/library
* ── Packages attached to the search path.
P ── Loaded and on-disk path mismatch.
──────────────────────────────────────────────────────────────────────────────Data Preparation
三个固定种子的样本:右偏生物标志物(对数正态,“待诊断”样本)、真正正态的样本(用于模拟包络)、两处理组的生物标志物分布(用于两样本 Q-Q 图)。GWAS 示例抽取 10,000 个零假设 p 值加 40 个关联位点。
set.seed(251)

n <- 500
skew_sample  <- rlnorm(n, meanlog = 1.2, sdlog = 0.8)  # 右偏生物标志物
norm_sample  <- rnorm(n, 50, 8)                        # 表现良好的对照
control_g <- rnorm(400, 42, 9)
case_g    <- rgamma(450, shape = 12, scale = 3.4)

pvals <- runif(10000)
idx <- sample(1:10000, 40)
pvals[idx] <- 10^(-rnorm(40, 3, 0.7))                  # 关联信号
Visualization
1. 偏态样本的正态 Q-Q 图
qq <- qqnorm(skew_sample, plot.it = FALSE)
# qqnorm 返回的分位数按数据原始顺序配对;按作图位置对两者排序得到干净的曲线
ord <- order(qq$x)
df1 <- data.frame(theoretical = qq$x[ord], sample = qq$y[ord])

ggplot(df1, aes(theoretical, sample)) +
  geom_point(color = "#2166AC", alpha = 0.65, size = 1.9) +
  geom_abline(slope = sd(skew_sample), intercept = mean(skew_sample),
              linetype = "dashed", color = "#B2182B") +
  labs(x = "Theoretical N(0,1) quantiles", y = "Sample quantiles",
       title = "Right-skewed sample: convex departure") +
  theme_bw(base_size = 11)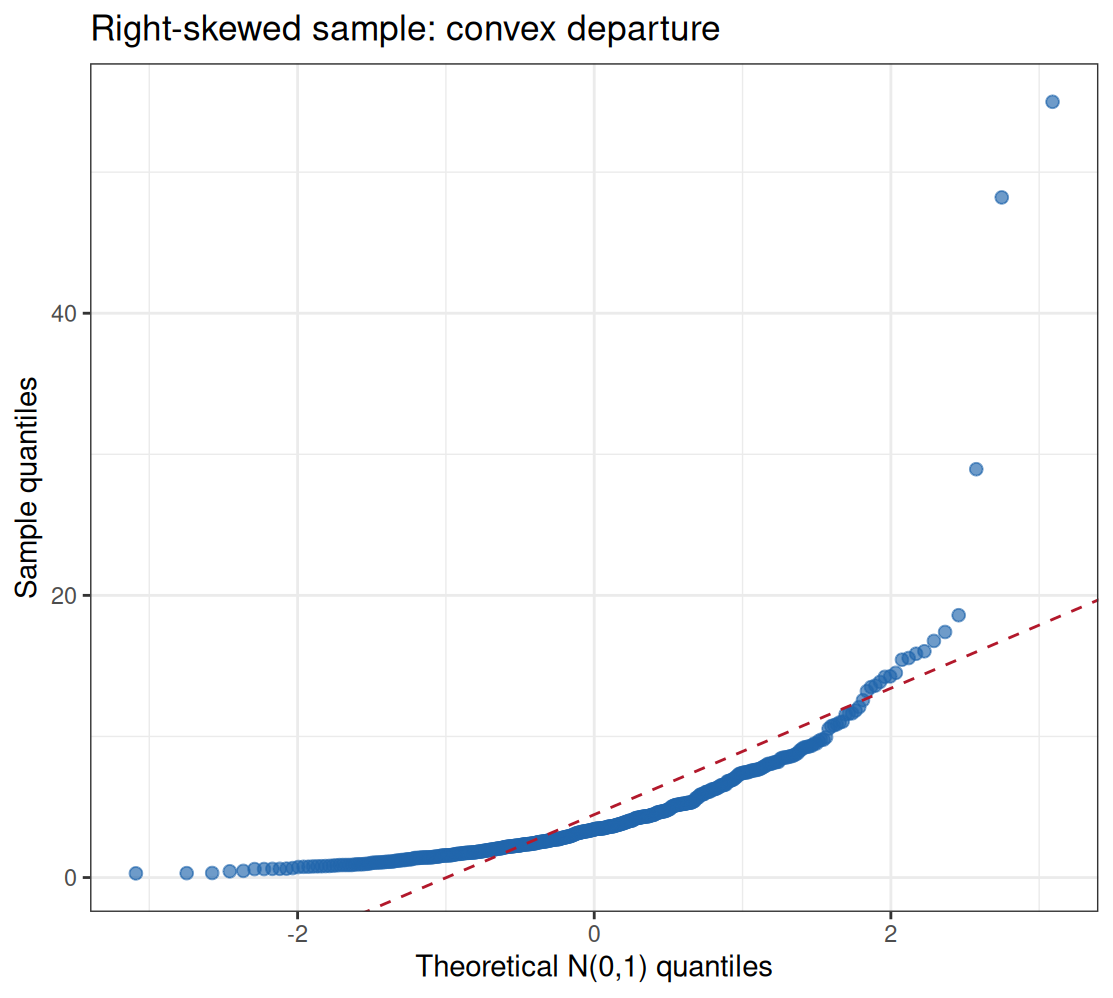
解读指南:右尾高于直线 = 厚的右尾;单条平滑弯折 = 偏态;两端同时翘起 = 厚尾。信任 t 区间之前,模型残差不应有这些形态。
2. 带 95% 模拟包络的 Q-Q 图
任何样本都有波动;问题是波动是否超出抽样噪声。从拟合的正态分布模拟大量样本、逐个排序,并对次序统计量做分位数带——落在包络外的点才是真实偏离。
M <- 500
srt <- matrix(rnorm(n * M, mean(norm_sample), sd(norm_sample)), nrow = n) |>
  apply(2, sort)
band <- t(apply(srt, 1, quantile, probs = c(0.025, 0.975)))
theory <- qnorm(ppoints(n))                # 升序作图位置
samp  <- sort(norm_sample)
env <- data.frame(theory, lo = band[, 1], hi = band[, 2], samp)

ggplot(env, aes(theory)) +
  geom_ribbon(aes(ymin = lo, ymax = hi), fill = "#2166AC", alpha = 0.18) +
  geom_point(aes(y = samp), color = "#2166AC", size = 1.8) +
  geom_abline(slope = sd(norm_sample), intercept = mean(norm_sample),
              linetype = "dashed", color = "grey40") +
  labs(x = "Theoretical quantiles", y = "Sample quantiles",
       title = "Normal sample with 95% simulation envelope") +
  theme_bw(base_size = 11)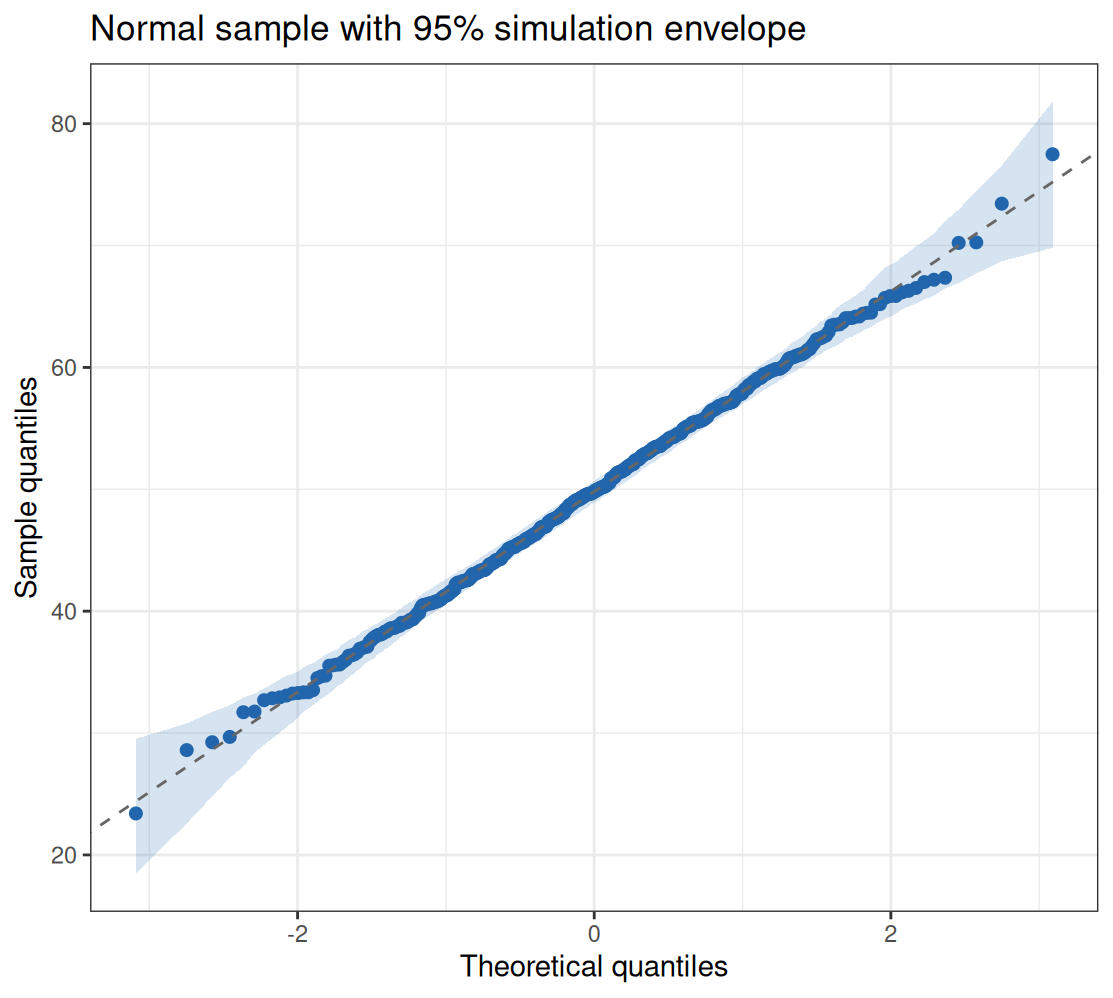
注记
qqnorm(x, plot.it = FALSE) 返回的分位数按数据原始顺序配对(y 是未排序的样本)。把它与排序后的样本配对——常见的复制粘贴失误——会得到毫无意义的点云。安全模式是 qnorm(ppoints(n)) 对 sort(x)。
3. 两样本 Q-Q 图
probs <- seq(0.01, 0.99, 0.01)
qx <- quantile(control_g, probs = probs, type = 7)
qy <- quantile(case_g, probs = probs, type = 7)

ggplot(data.frame(x = qx, y = qy), aes(x, y)) +
  geom_point(color = "#2166AC", size = 2) +
  geom_abline(slope = 1, intercept = 0, linetype = "dashed", color = "#B2182B") +
  labs(x = "Quantiles: Control biomarker", y = "Quantiles: Case biomarker",
       title = "Two-sample Q-Q plot") +
  theme_bw(base_size = 11)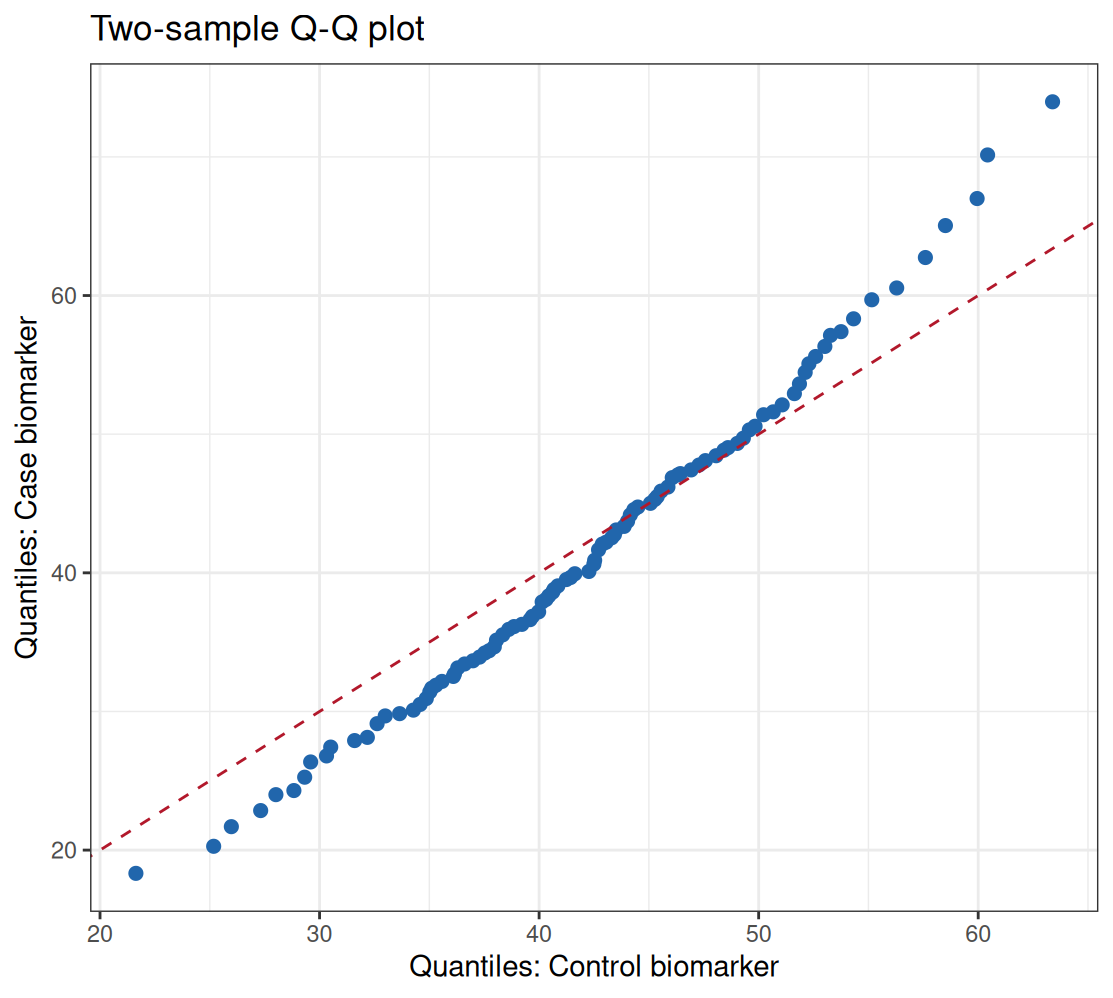
此图不假定任一方为正态即可比较整个分布——平行平移意味着位置移动,斜率变化意味着尺度差异。
4. 带基因组膨胀因子的 GWAS Q-Q 图
基因组膨胀因子 λ 是观测的中位检验统计量与其零假设期望之比;接近 1.0 表示零假设校准良好。
chisq <- qchisq(1 - pvals, 1)
lambda <- median(chisq) / qchisq(0.5, 1)
cat(sprintf("Genomic inflation factor lambda_GC = %.3f\n", lambda))
Genomic inflation factor lambda_GC = 1.007qq(pvals, main = sprintf("GWAS Q-Q plot (lambda_GC = %.2f)", lambda))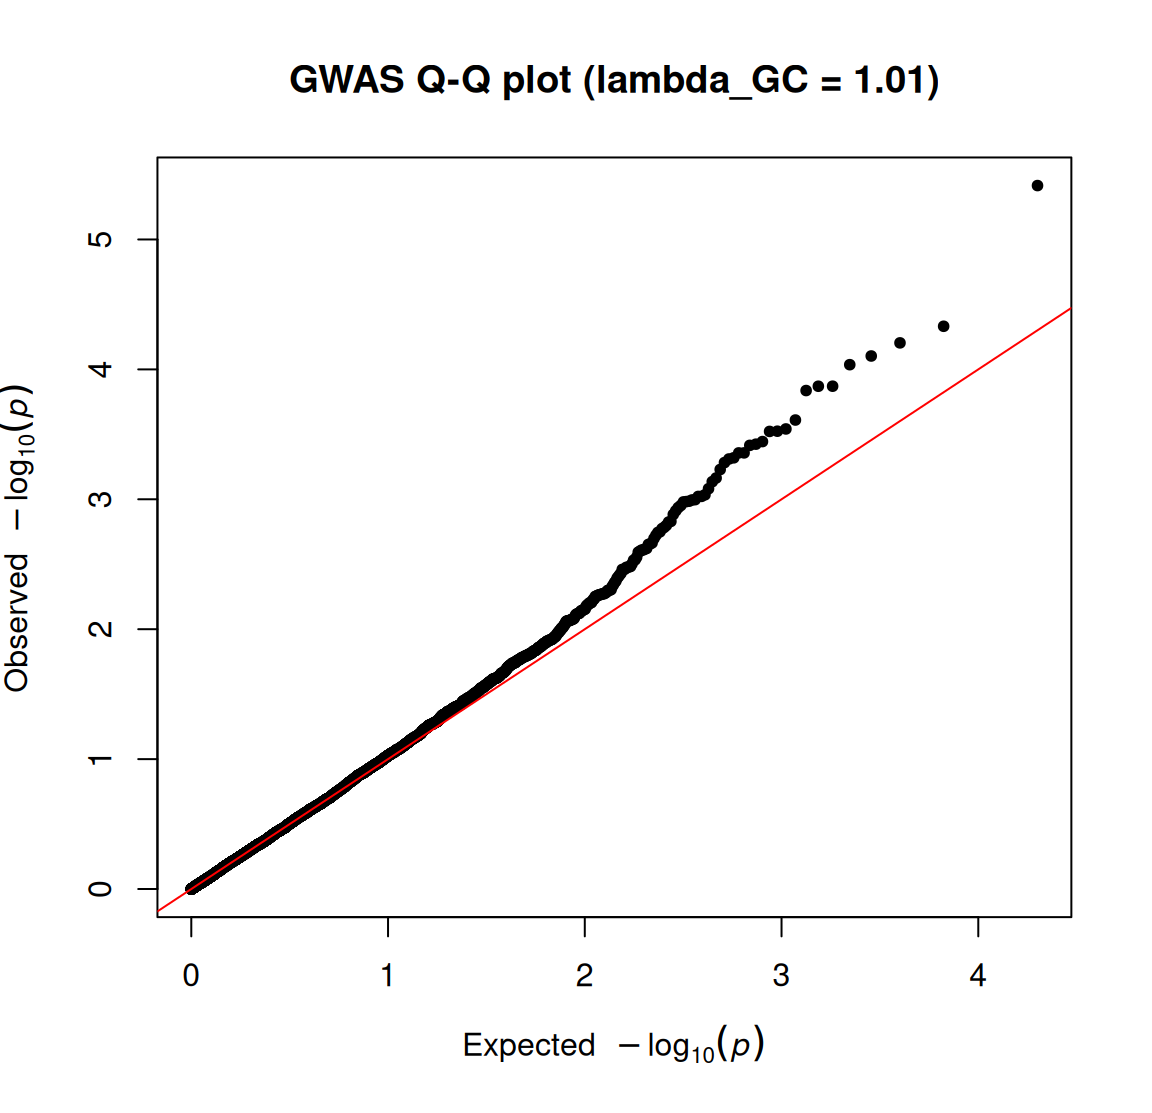
零假设校准良好时点沿对角线分布;λ 接近 1.0 表示无系统膨胀(λ ≫ 1.1 提示群体分层或批次效应),尾部抬起而主体贴线是真实关联的特征。
提示实践要点
- 参考线选择:过四分位数的线(
stat_qq_line()的默认)比均值/标准差线在尾部狂野时更稳健。 - 没有包络就不要下结论:没有参考带的 Q-Q 图会把普通抽样噪声过度解读,尤其 n < 100 时。
- Q-Q 图要用原始样本——画 z 分数只是给坐标轴改名。
- GWAS 中 λ 按中位 χ²(1 自由度)计算;每张 Q-Q 图旁都应报告 λ,λ > 1.1 时先查分层再谈位点。
Application
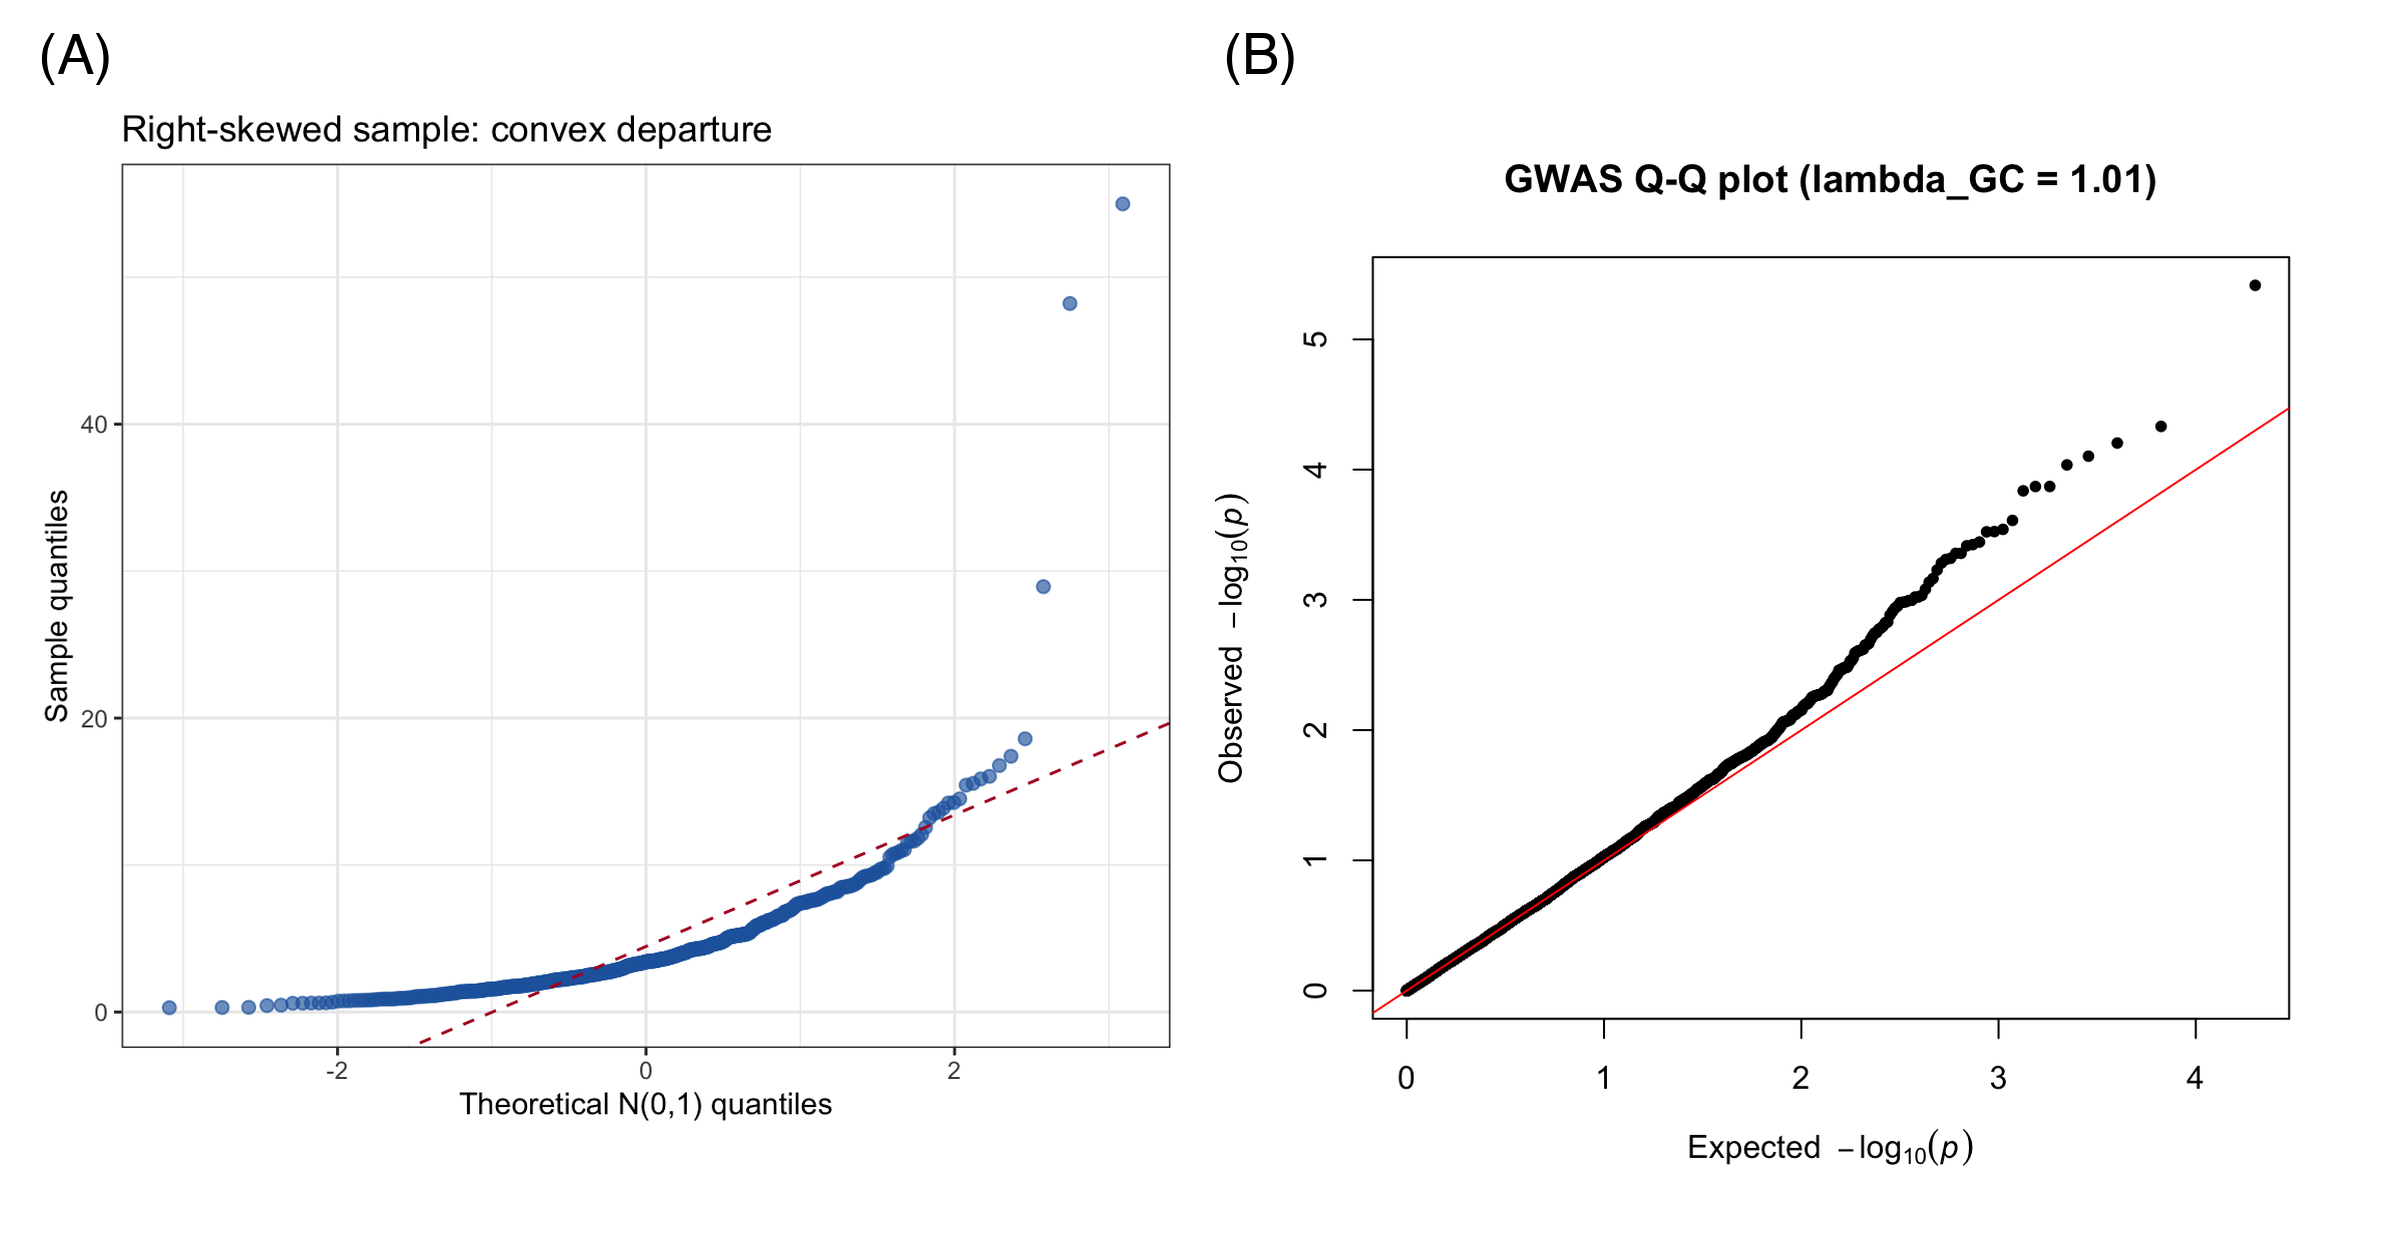
Q-Q 图出现在每篇 GWAS/组学论文(p 值校准)、回归诊断(残差正态性)与方法比较研究(分布级一致性)中。下图模拟典型论文版式:(A) 带模拟包络的样本 Q-Q 图与 (B) 带 λ 的 GWAS p 值 Q-Q 图。
Reference
[1] Razali NM, Wah YB. Power comparisons of Shapiro-Wilk, Kolmogorov-Smirnov, Lilliefors and Anderson-Darling tests. J Stat Model Anal. 2011;2(1):21-33.
[2] Turner SD. qqman: an R package for visualizing GWAS results using Q-Q and Manhattan plots. J Open Source Softw. 2018;3(25):731. doi:10.21105/joss.00731