# 安装必要的包
if (!requireNamespace("rms", quietly = TRUE)) {
  install.packages("rms")
}
if (!requireNamespace("dcurves", quietly = TRUE)) {
  install.packages("dcurves")
}

# 加载包
library(survival)
library(dplyr)
library(ggplot2)
library(rms)
library(dcurves)决策曲线分析
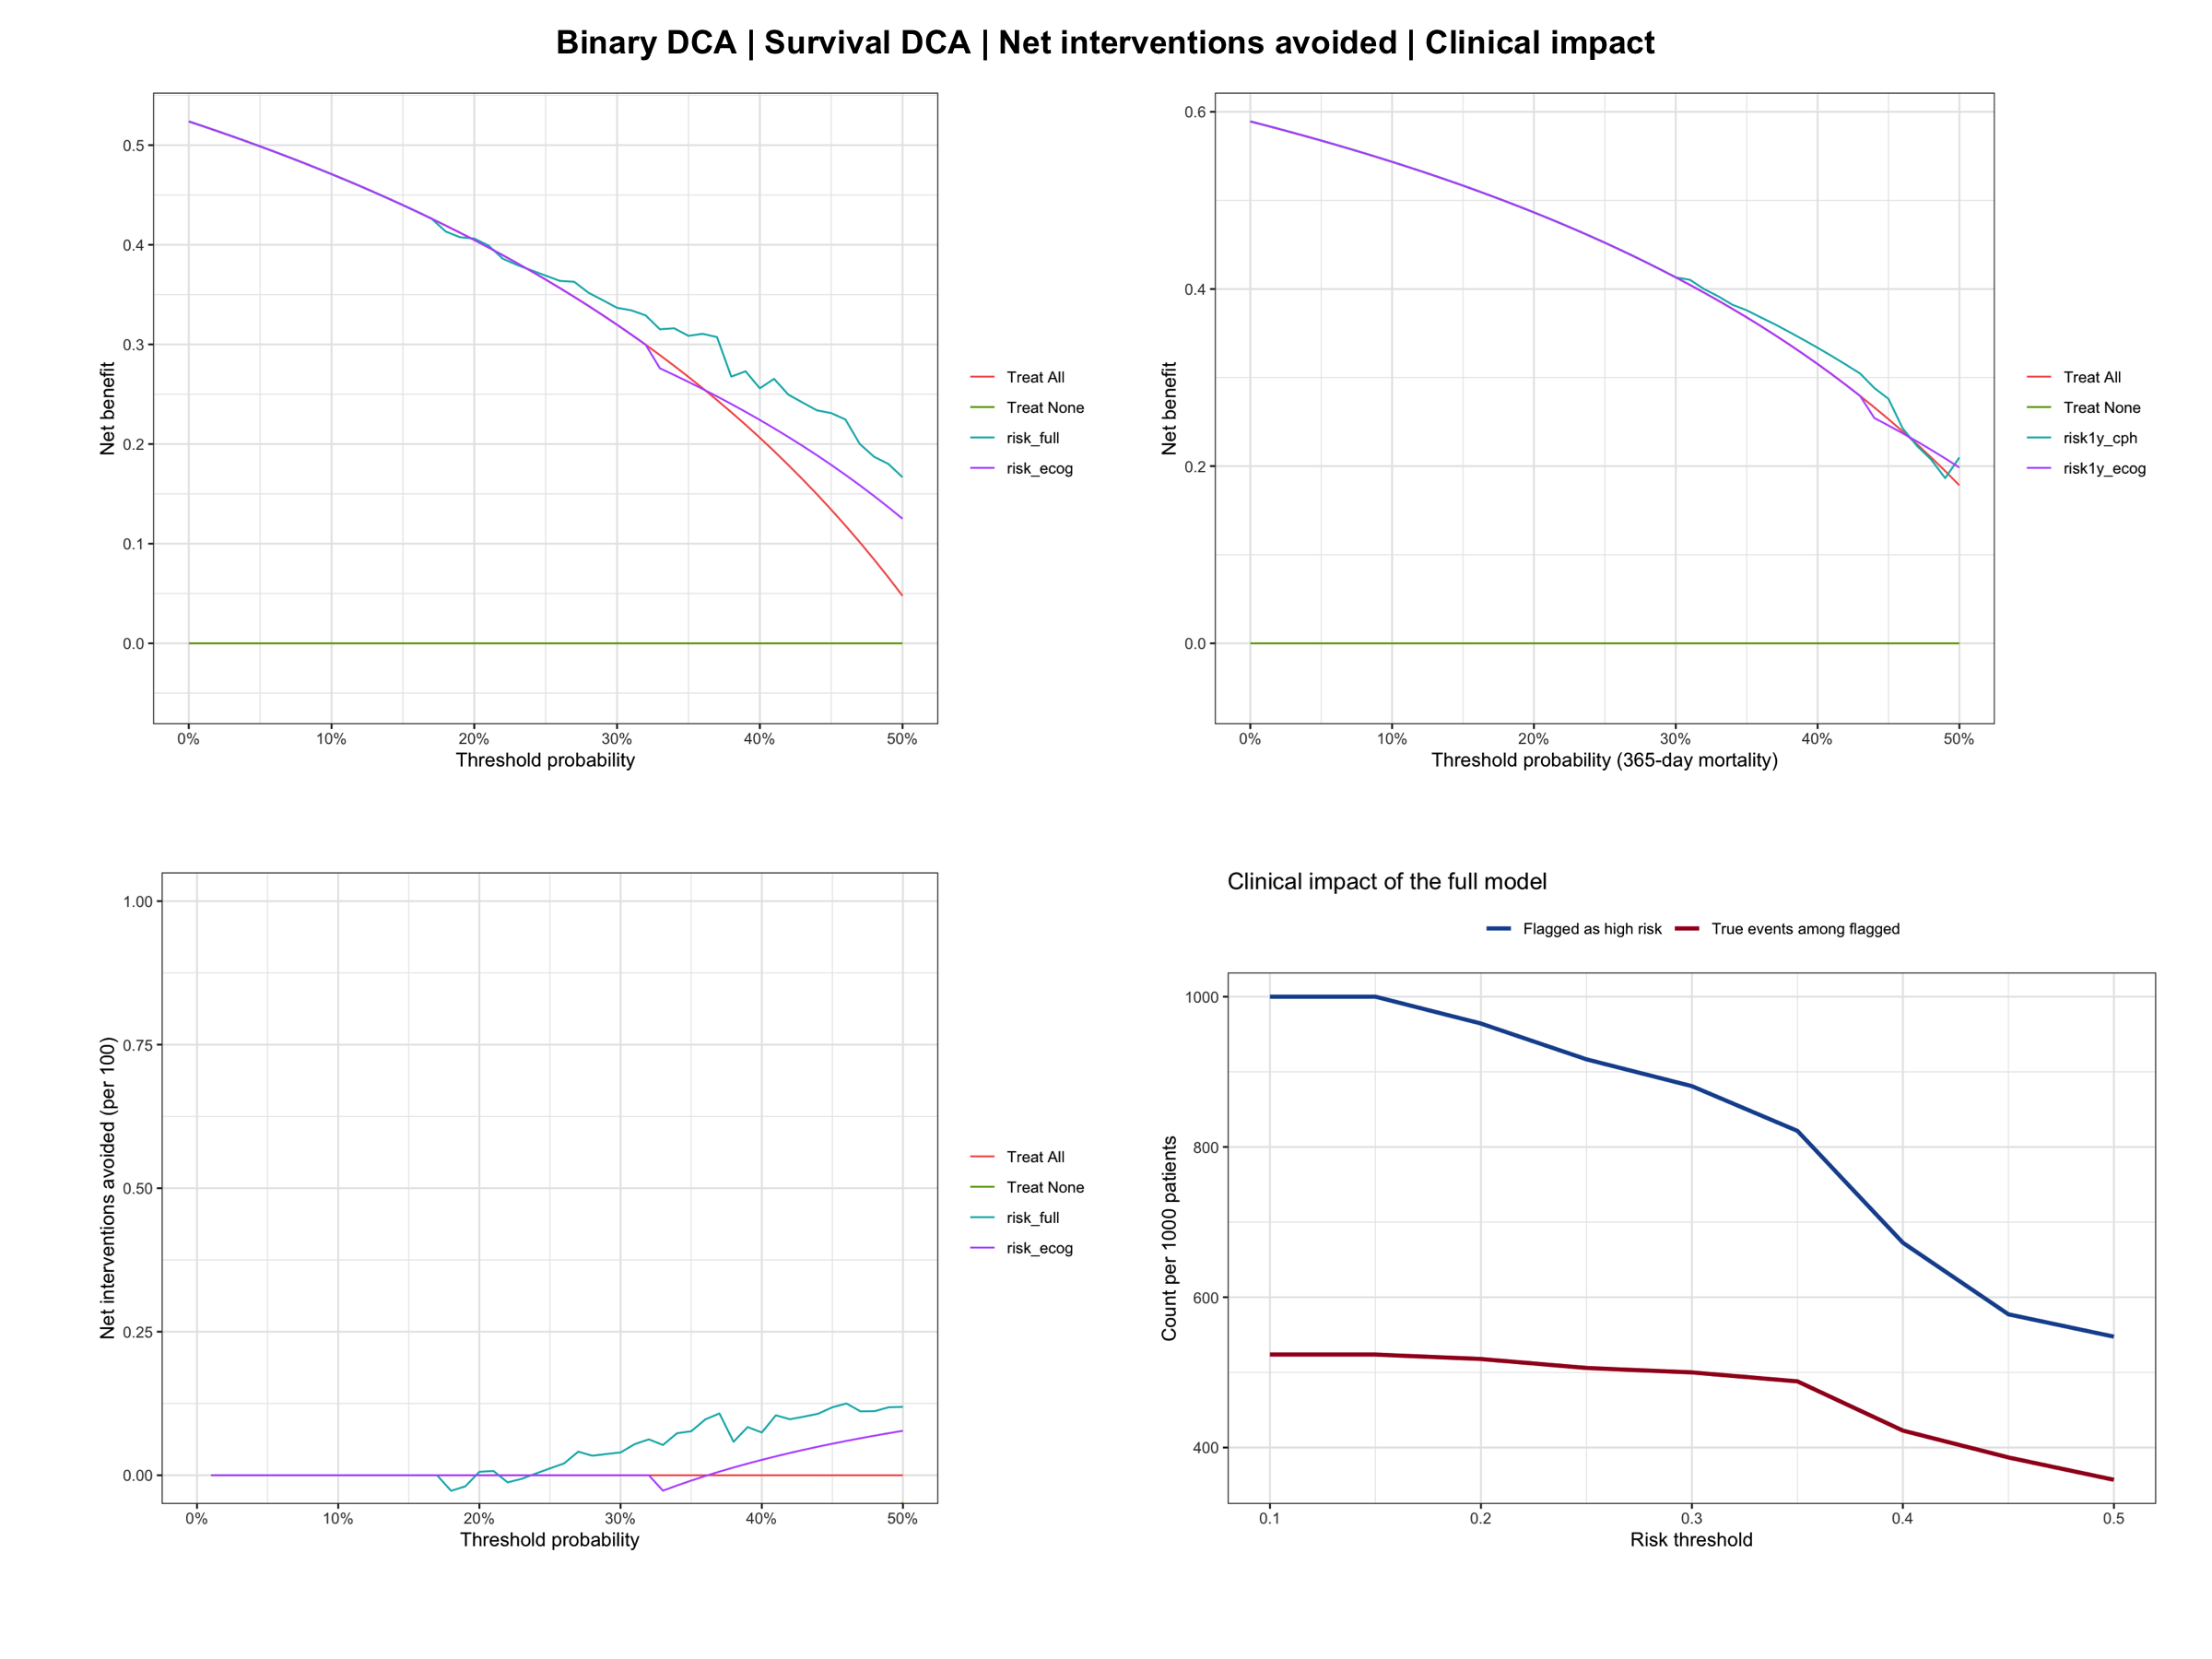
决策曲线分析(Decision Curve Analysis,DCA)评估预测模型的临床实用性:在一系列风险阈值下,依据模型预测采取行动相比“全部干预”或“全不干预”能带来多少净获益(net benefit)?净获益等于每名患者增加的真阳性数减去假阳性数,其中每个假阳性按阈值所隐含的危害-获益比加权 [1]。只有当模型的净获益在相关阈值范围内同时超过两种默认策略时,模型才具有临床实用性——仅靠区分度(AUC)和校准无法回答这个问题 [2]。与 ROC 曲线、校准曲线一样,DCA 是临床预测模型的标准评估图之一。
本教程使用 dcurves 包 [3](方法原作者维护的现行实现;旧的 rmda 包已从 CRAN 下架)涵盖 R 中四种 DCA 工作流:
- 二元终点的决策曲线(两个竞争模型);
- 生存终点在固定时间点的决策曲线;
- Net interventions avoided——每 100 名患者可安全减少的干预数;
- 手工计算的临床影响曲线(每 1000 名患者检出的事件数)。
示例
环境配置
系统要求:跨平台(Linux/MacOS/Windows)
编程语言:R
依赖包:
survival;dplyr;rms;dcurves;ggplot2
sessioninfo::session_info("attached")─ Session info ───────────────────────────────────────────────────────────────
setting value
version R version 4.6.1 (2026-06-24)
os Ubuntu 24.04.5 LTS
system x86_64, linux-gnu
ui X11
language (EN)
collate C.UTF-8
ctype C.UTF-8
tz UTC
date 2026-10-29
pandoc 3.1.3 @ /usr/bin/ (via rmarkdown)
quarto 1.10.19 @ /usr/local/bin/quarto
─ Packages ───────────────────────────────────────────────────────────────────
! package * version date (UTC) lib source
dcurves * 0.5.1 2025-11-15 [1] RSPM
P dplyr * 1.2.1 2026-04-03 [?] RSPM
P ggplot2 * 4.0.3.9000 2026-10-26 [?] Github (tidyverse/ggplot2@b638d65)
P Hmisc * 5.3-0 2026-09-06 [?] RSPM
P rms * 8.1-1 2026-02-18 [?] RSPM
survival * 3.8-6 2026-01-16 [3] CRAN (R 4.6.1)
[1] /home/runner/.cache/R/renv/library/Bizard-5140bdc6/linux-ubuntu-noble/R-4.6/x86_64-pc-linux-gnu
[2] /home/runner/work/_temp/Library
[3] /opt/R/4.6.1/lib/R/library
* ── Packages attached to the search path.
P ── Loaded and on-disk path mismatch.
──────────────────────────────────────────────────────────────────────────────数据准备
我们使用 survival 包内置的 lung 数据集(北中部癌症治疗组肺癌临床试验)[4]。传入 dca() 的每条策略都必须是 0 到 1 之间的预测概率,因此我们构造:
-
risk_full/risk_ecog:完整与简单 logistic 模型预测的 1 年死亡率(二元终点); -
risk1y_cph/risk1y_ecog:完整与简单 Cox 模型预测的 1 年死亡风险(生存终点)。
data(lung, package = "survival")

lung2 <- lung %>%
  filter(complete.cases(age, sex, ph.ecog, ph.karno, pat.karno, meal.cal, wt.loss)) %>%
  mutate(y1y = as.integer(time < 365 & status == 2))  # 365 天内死亡
  # 注意:365 天内删失的患者在此被计为非事件。

# 二元终点:logistic 模型
m_full   <- glm(y1y ~ age + sex + ph.ecog + meal.cal + wt.loss,
                data = lung2, family = binomial)
m_simple <- glm(y1y ~ ph.ecog, data = lung2, family = binomial)
lung2$risk_full  <- fitted(m_full)
lung2$risk_ecog  <- fitted(m_simple)

# 生存终点:Cox 模型预测的 1 年风险
dd <- datadist(lung2)
options(datadist = "dd")
cph_full <- cph(Surv(time, status) ~ age + sex + ph.ecog,
                data = lung2, x = TRUE, y = TRUE, surv = TRUE, time.inc = 365)
cph_ecog <- cph(Surv(time, status) ~ ph.ecog,
                data = lung2, x = TRUE, y = TRUE, surv = TRUE, time.inc = 365)
lung2$risk1y_cph  <- 1 - Survival(cph_full)(365, predict(cph_full, type = "lp"))
lung2$risk1y_ecog <- 1 - Survival(cph_ecog)(365, predict(cph_ecog, type = "lp"))

head(lung2[, c("y1y", "risk_full", "risk_ecog", "risk1y_cph", "risk1y_ecog")])
y1y risk_full risk_ecog risk1y_cph risk1y_ecog
2 0 0.3355593 0.3252807 0.5136877 0.4310632
4 1 0.6045635 0.5344500 0.6454549 0.5935850
6 0 0.6759279 0.5344500 0.6941938 0.5935850
7 1 0.6826392 0.7321672 0.6593625 0.7624603
8 1 0.6638663 0.7321672 0.6679848 0.7624603
9 1 0.6584805 0.5344500 0.6339175 0.5935850可视化
1. 二元终点的决策曲线
dca() 总会画出两种默认策略——treat all 与 treat none——以及每个模型一条曲线。只应展示有临床意义的阈值范围(这里是 0–50%)[2]。
dca_bin <- dca(y1y ~ risk_full + risk_ecog, data = lung2,
               thresholds = seq(0, 0.5, 0.01))
plot(dca_bin, smooth = FALSE) +
  labs(x = "Threshold probability", y = "Net benefit") +
  theme_bw()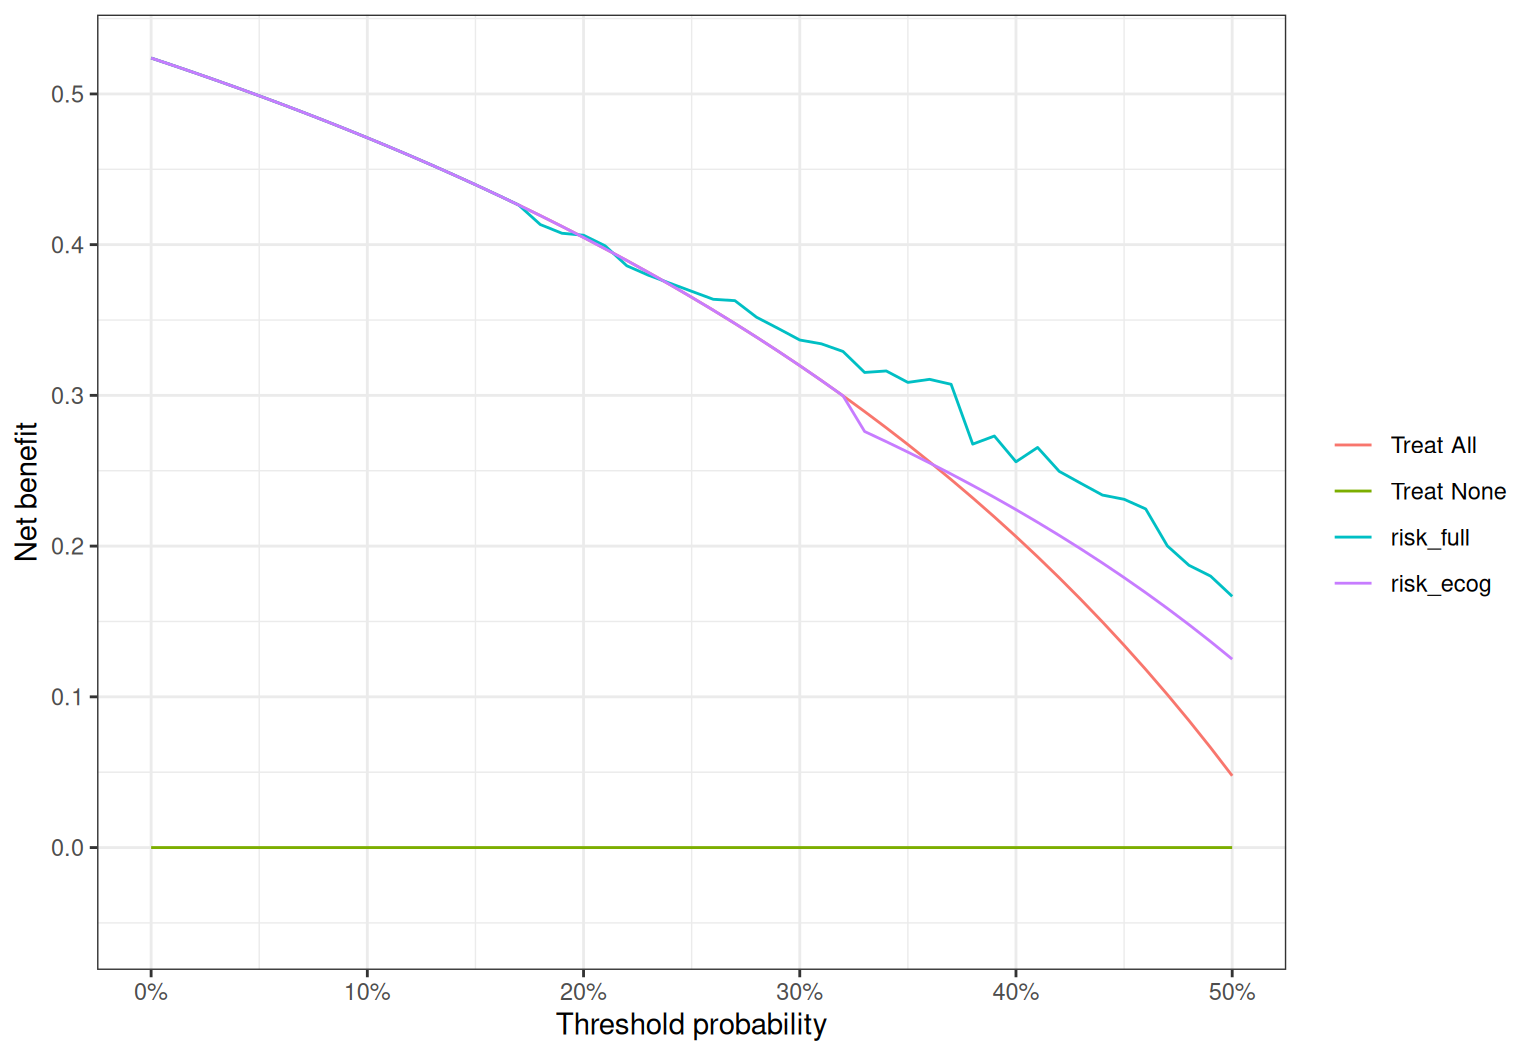
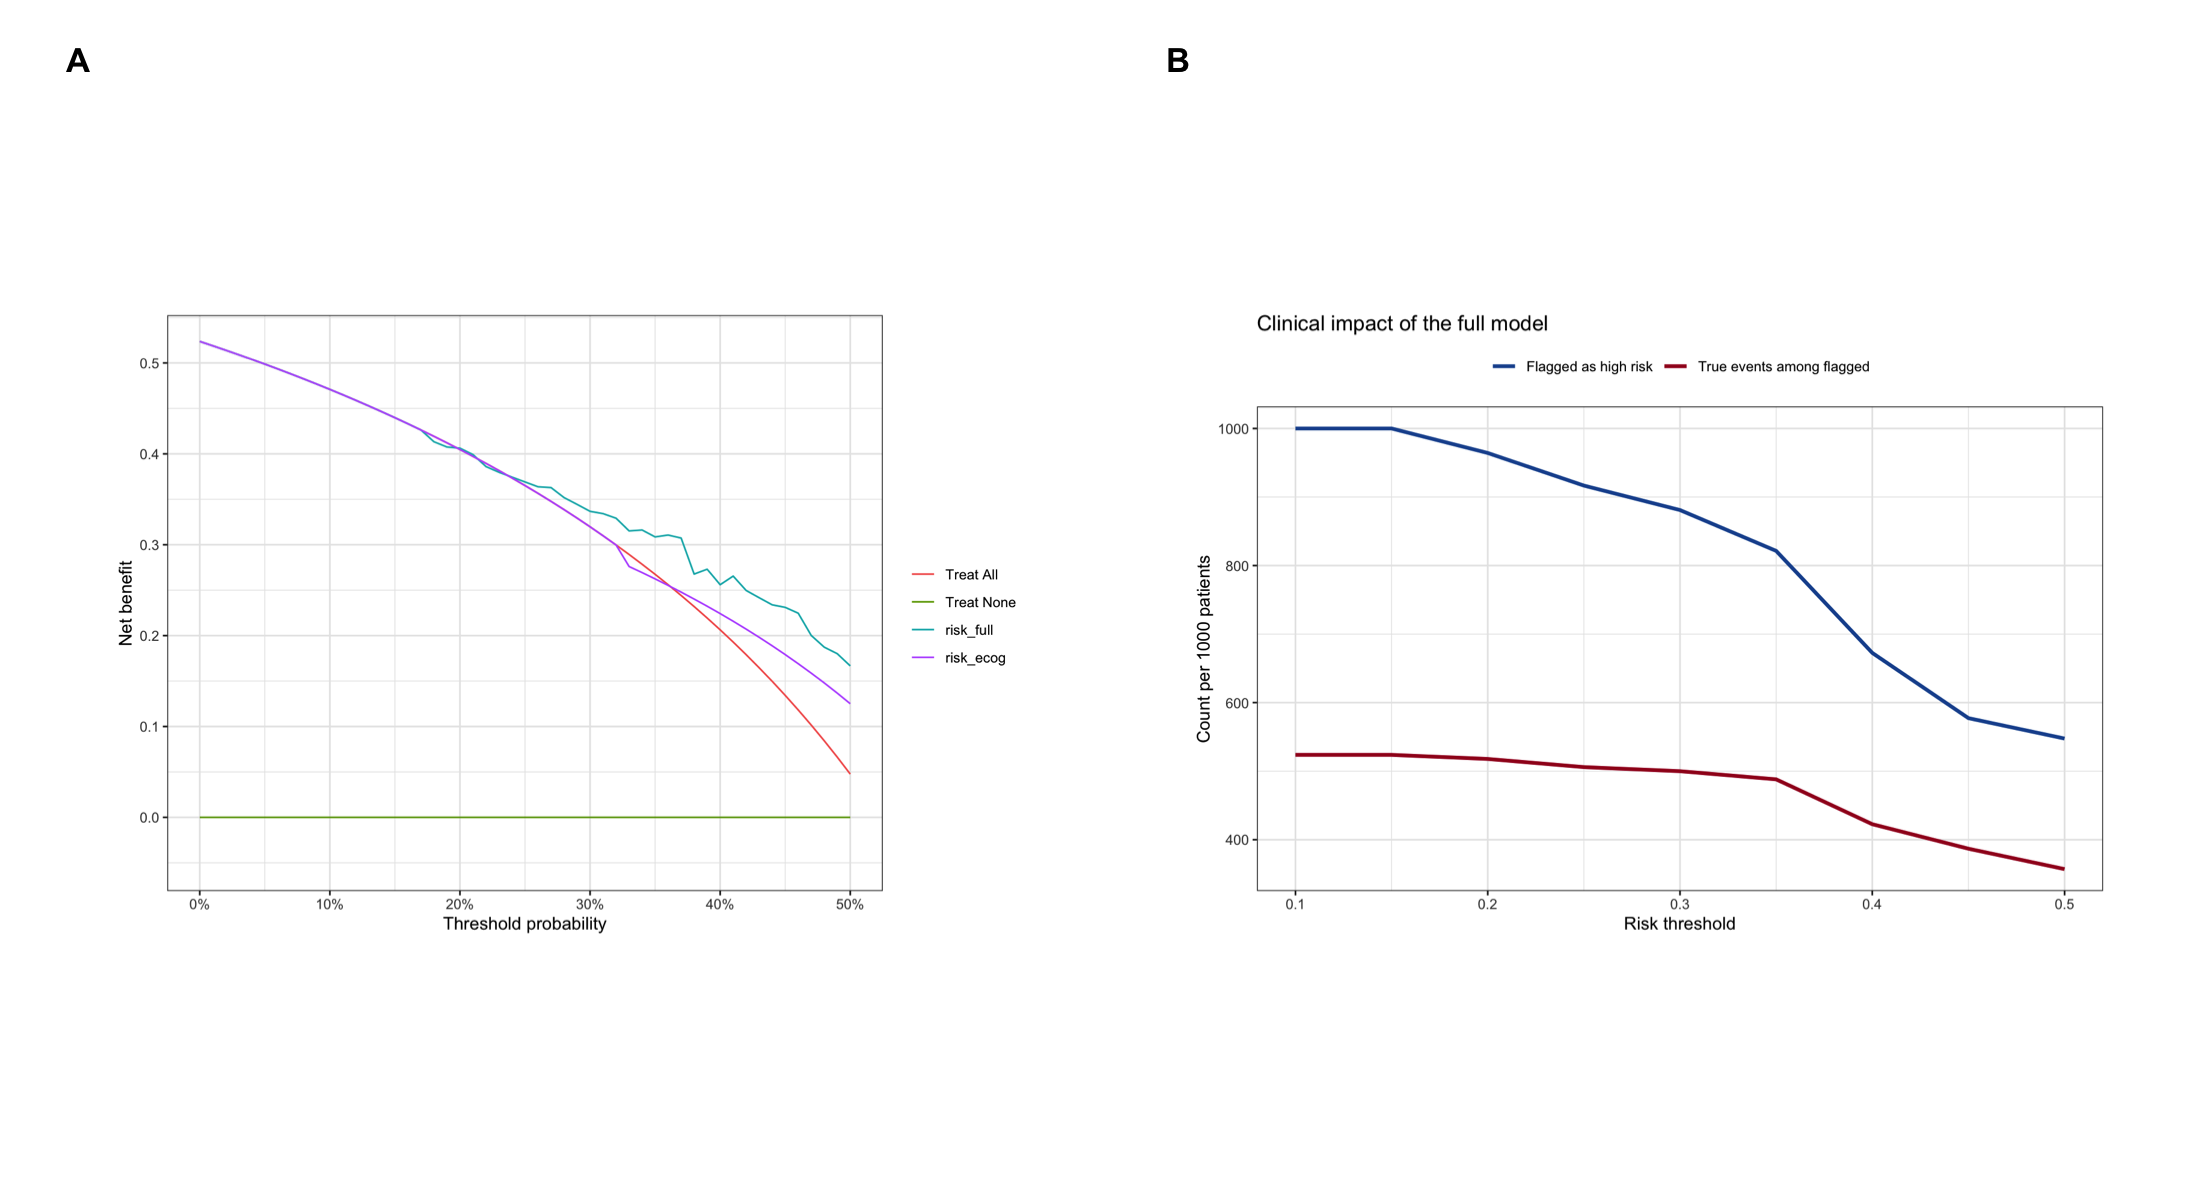
读图方式:在阈值为 20% 时(例如“预测 1 年死亡风险超过 20% 就加强随访”),净获益高于 treat all 的模型可以安全地识别患者;当模型曲线低于两种默认策略时,模型没有附加价值。
2. 生存终点的决策曲线
对于删失的生存结局,传入 Surv 对象和关注的时间点;dcurves 会基于 Kaplan-Meier 估计该时间点的事件率。
dca_surv <- dca(Surv(time, status) ~ risk1y_cph + risk1y_ecog, data = lung2,
                time = 365, thresholds = seq(0, 0.5, 0.01))
plot(dca_surv, smooth = FALSE) +
  labs(x = "Threshold probability (365-day mortality)", y = "Net benefit") +
  theme_bw()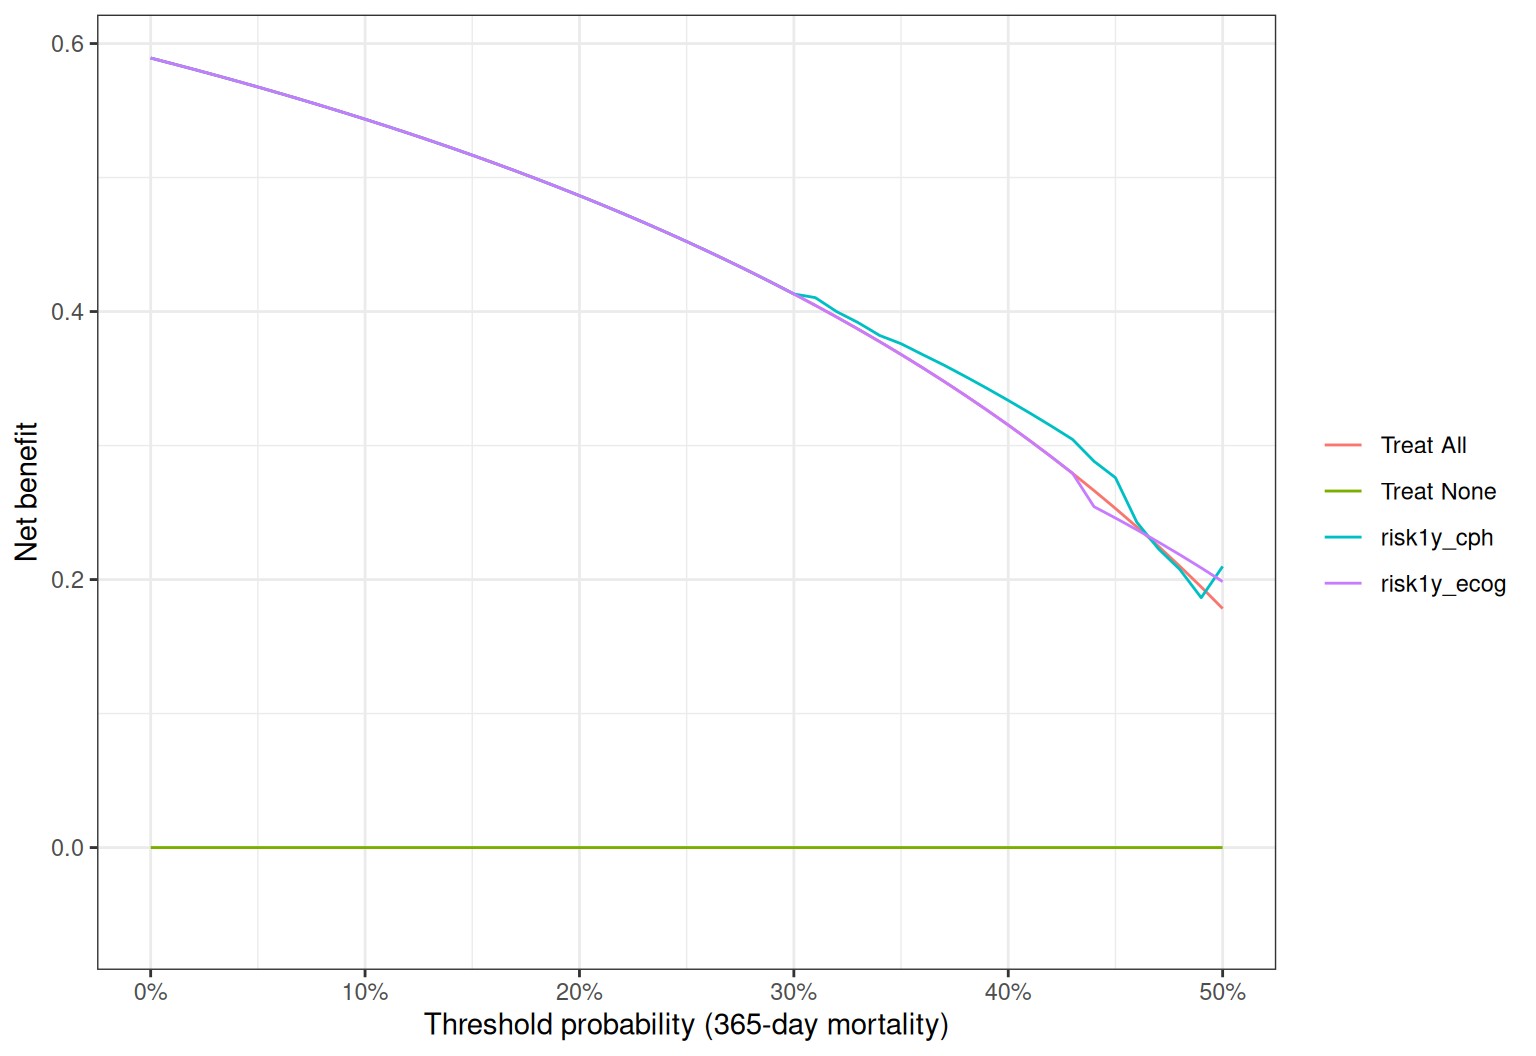
3. Net interventions avoided
更直观的转译:在每个阈值下,与“全部干预”相比、在漏掉相同数量事件的前提下,每 100 名患者可以避免多少次干预?
nia <- net_intervention_avoided(dca_bin, nper = 100)
plot(nia, smooth = FALSE) +
  labs(x = "Threshold probability", y = "Net interventions avoided (per 100)") +
  theme_bw()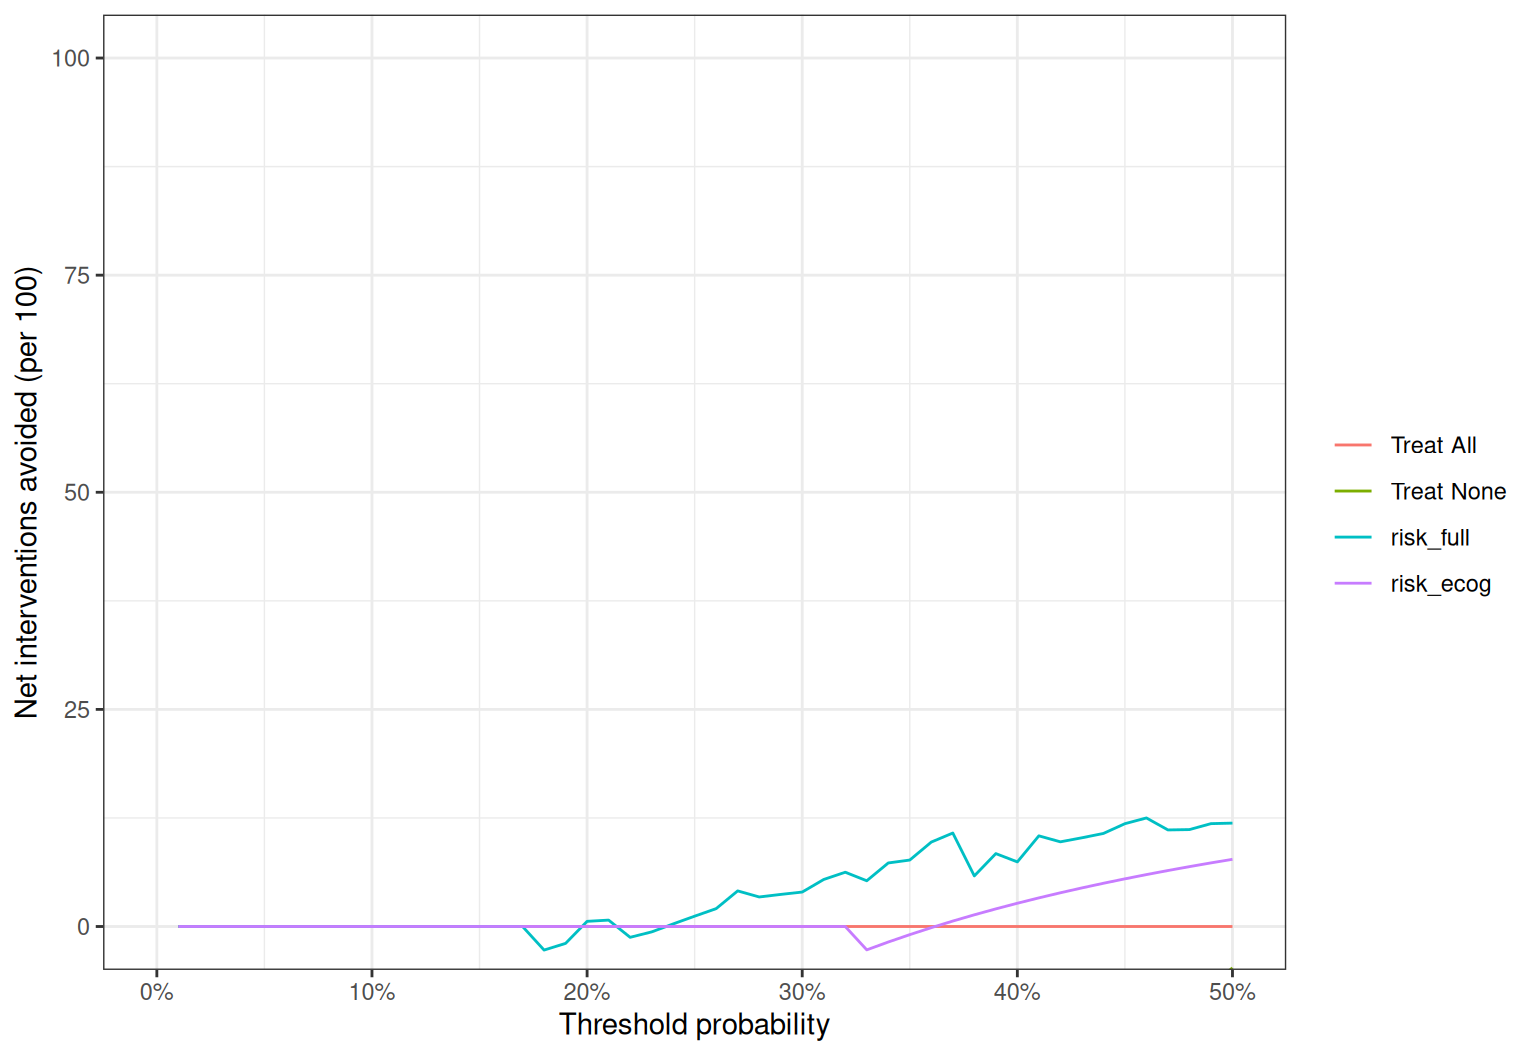
正值表示使用模型可以在漏诊事件数相同的情况下,每 100 名患者相对“全部干预”节省相应次数的干预。
4. 手工计算的临床影响曲线
临床影响曲线展示的是:随着阈值变化,每 1000 名患者中有多少人被判定为高风险、其中多少是真实事件 [1]。dcurves 没有内置这一变体,但可以直接计算:
n <- nrow(lung2)
impact <- do.call(rbind, lapply(seq(0.1, 0.5, 0.05), function(t) {
  flagged <- lung2$risk_full >= t
  data.frame(threshold = t,
             high_risk = sum(flagged) / n * 1000,
             events_detected = sum(lung2$y1y[flagged]) / n * 1000)
}))

ggplot(impact, aes(x = threshold)) +
  geom_line(aes(y = high_risk, color = "Flagged as high risk"), linewidth = 1.1) +
  geom_line(aes(y = events_detected, color = "True events among flagged"), linewidth = 1.1) +
  scale_color_manual(values = c("#2166AC", "#B2182B"), name = NULL) +
  labs(x = "Risk threshold",
       y = "Count per 1000 patients",
       title = "Clinical impact of the full model") +
  theme_bw() +
  theme(legend.position = "top")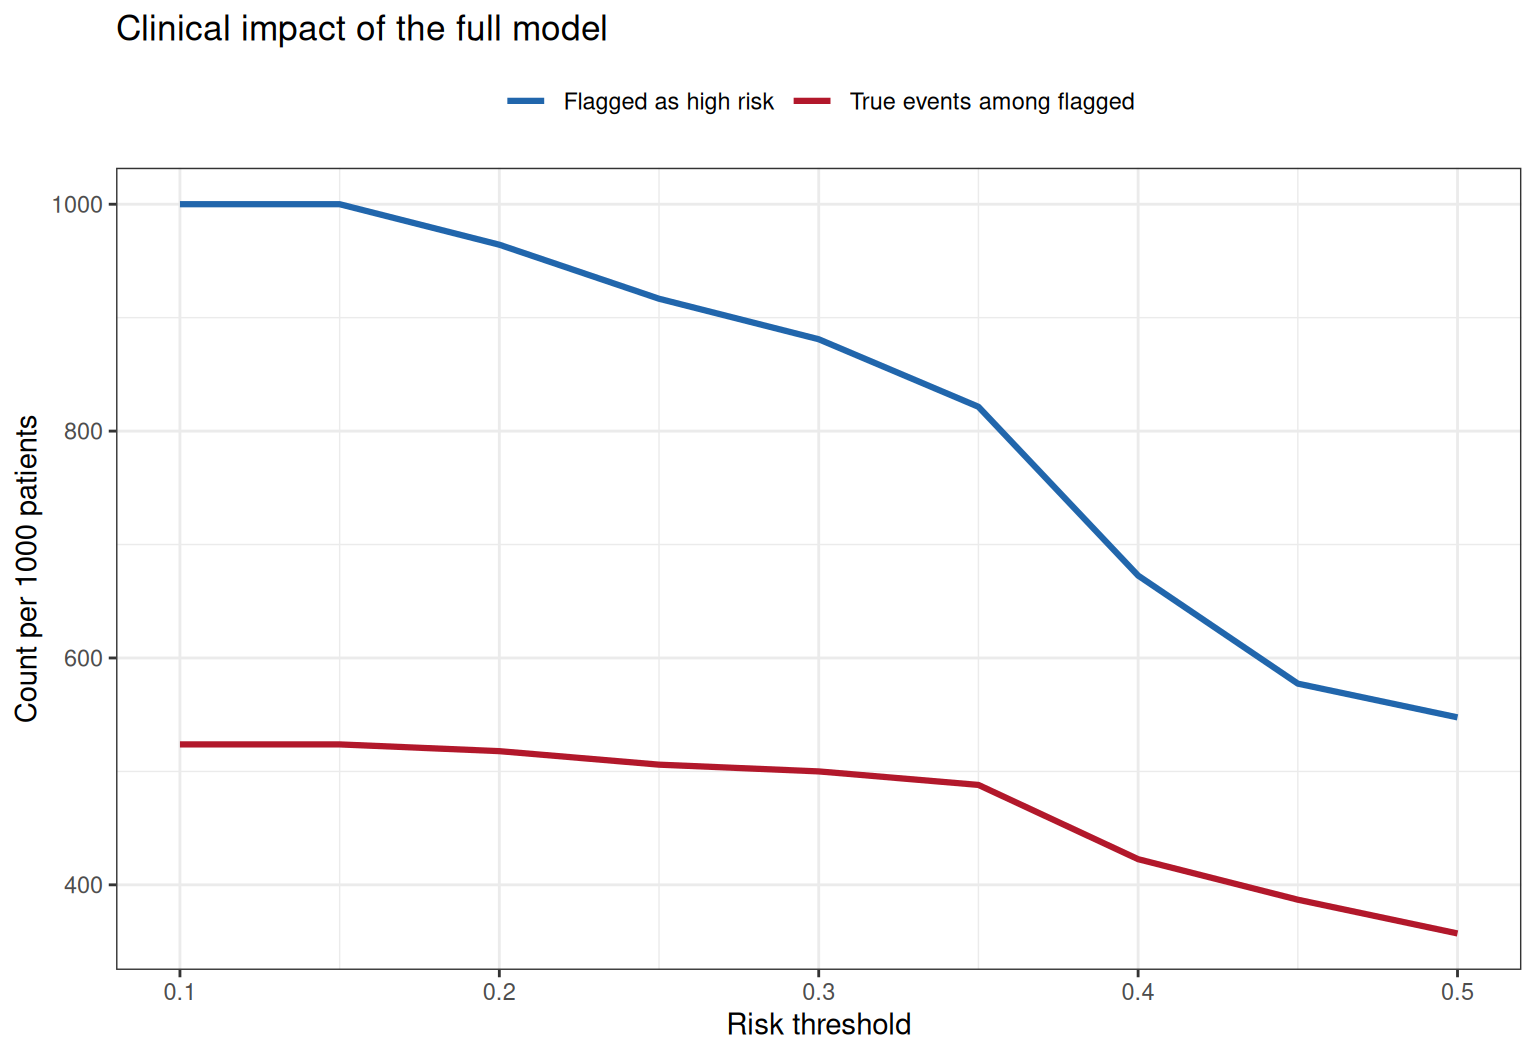
两条线之间的差值就是每个阈值下每 1000 名患者中“不必要的干预”数量——在临床相关阈值处差值越小,说明模型越有用。
应用
决策曲线通常与 ROC 曲线、校准曲线一同出现在临床预测模型研究中。下图展示典型的组合方式:(A) 各阈值下的决策曲线;(B) 临床影响曲线。
参考文献
[1] Vickers AJ, Elkin EB. Decision curve analysis: a novel method for evaluating prediction models. Med Decis Making. 2006;26(6):565-574. doi:10.1177/0272989X06295361
[2] Vickers AJ, van Calster B, Steyerberg EW. A simple, step-by-step guide to interpreting decision curve analysis. Diagn Progn Res. 2019;3(1):18. doi:10.1186/s41512-019-0064-7
[3] Sjoberg DD. dcurves: Decision Curve Analysis for Model Evaluation. R package version 0.5.1. doi:10.32614/CRAN.package.dcurves
[4] Loprinzi CL, Laurie JA, Wieand HS, et al. Prospective evaluation of prognostic variables from patient-completed questionnaires. North Central Cancer Treatment Group. J Clin Oncol. 1994;12(3):601-607. doi:10.1200/JCO.1994.12.3.601