# Installing necessary packages
if (!requireNamespace("tidyverse", quietly = TRUE)) {
  install.packages("tidyverse")
}
if (!requireNamespace("ggbeeswarm", quietly = TRUE)) {
  install.packages("ggbeeswarm")
}

# Load packages
library(tidyverse)
library(ggbeeswarm)环形多轨道样本注释图
环形多轨道样本注释图把队列中的每个样本排成圆环上的一个扇区:每个扇区在外缘有一个样本标签,同心圆环轨道编码不同变量(连续变量以棒棒糖轨道呈现、圆点离圆心的距离表示数值大小,分类变量以彩色色带呈现),圆环缺口处安放队列汇总——每条连续轨道对应一块白色面板(箱线图、蜂群散点与四分位标签),每条分类轨道对应一条 100% 堆叠比例柱,并配有两个连续标尺的紧凑数值轴。每块汇总面板正对它自己的轨道(径向位置镜像到左侧),且所有面板统一高度,使缺口区读起来是一列整齐的统计图;顶部图例按轨道逐行自动生成。它专为需要同时展示大量样本与多变量信息的队列图而设计(参考图展示了 108 名纵向多组学队列参与者),个体层面的模式、群体构成与总体分布可在一瞥之间同读。本教程复现《顶刊图社》系列(第094期,复现自 Shen 等发表于 Nature Aging 2024 的图)介绍的图表类型,见文末参考文献。
示例
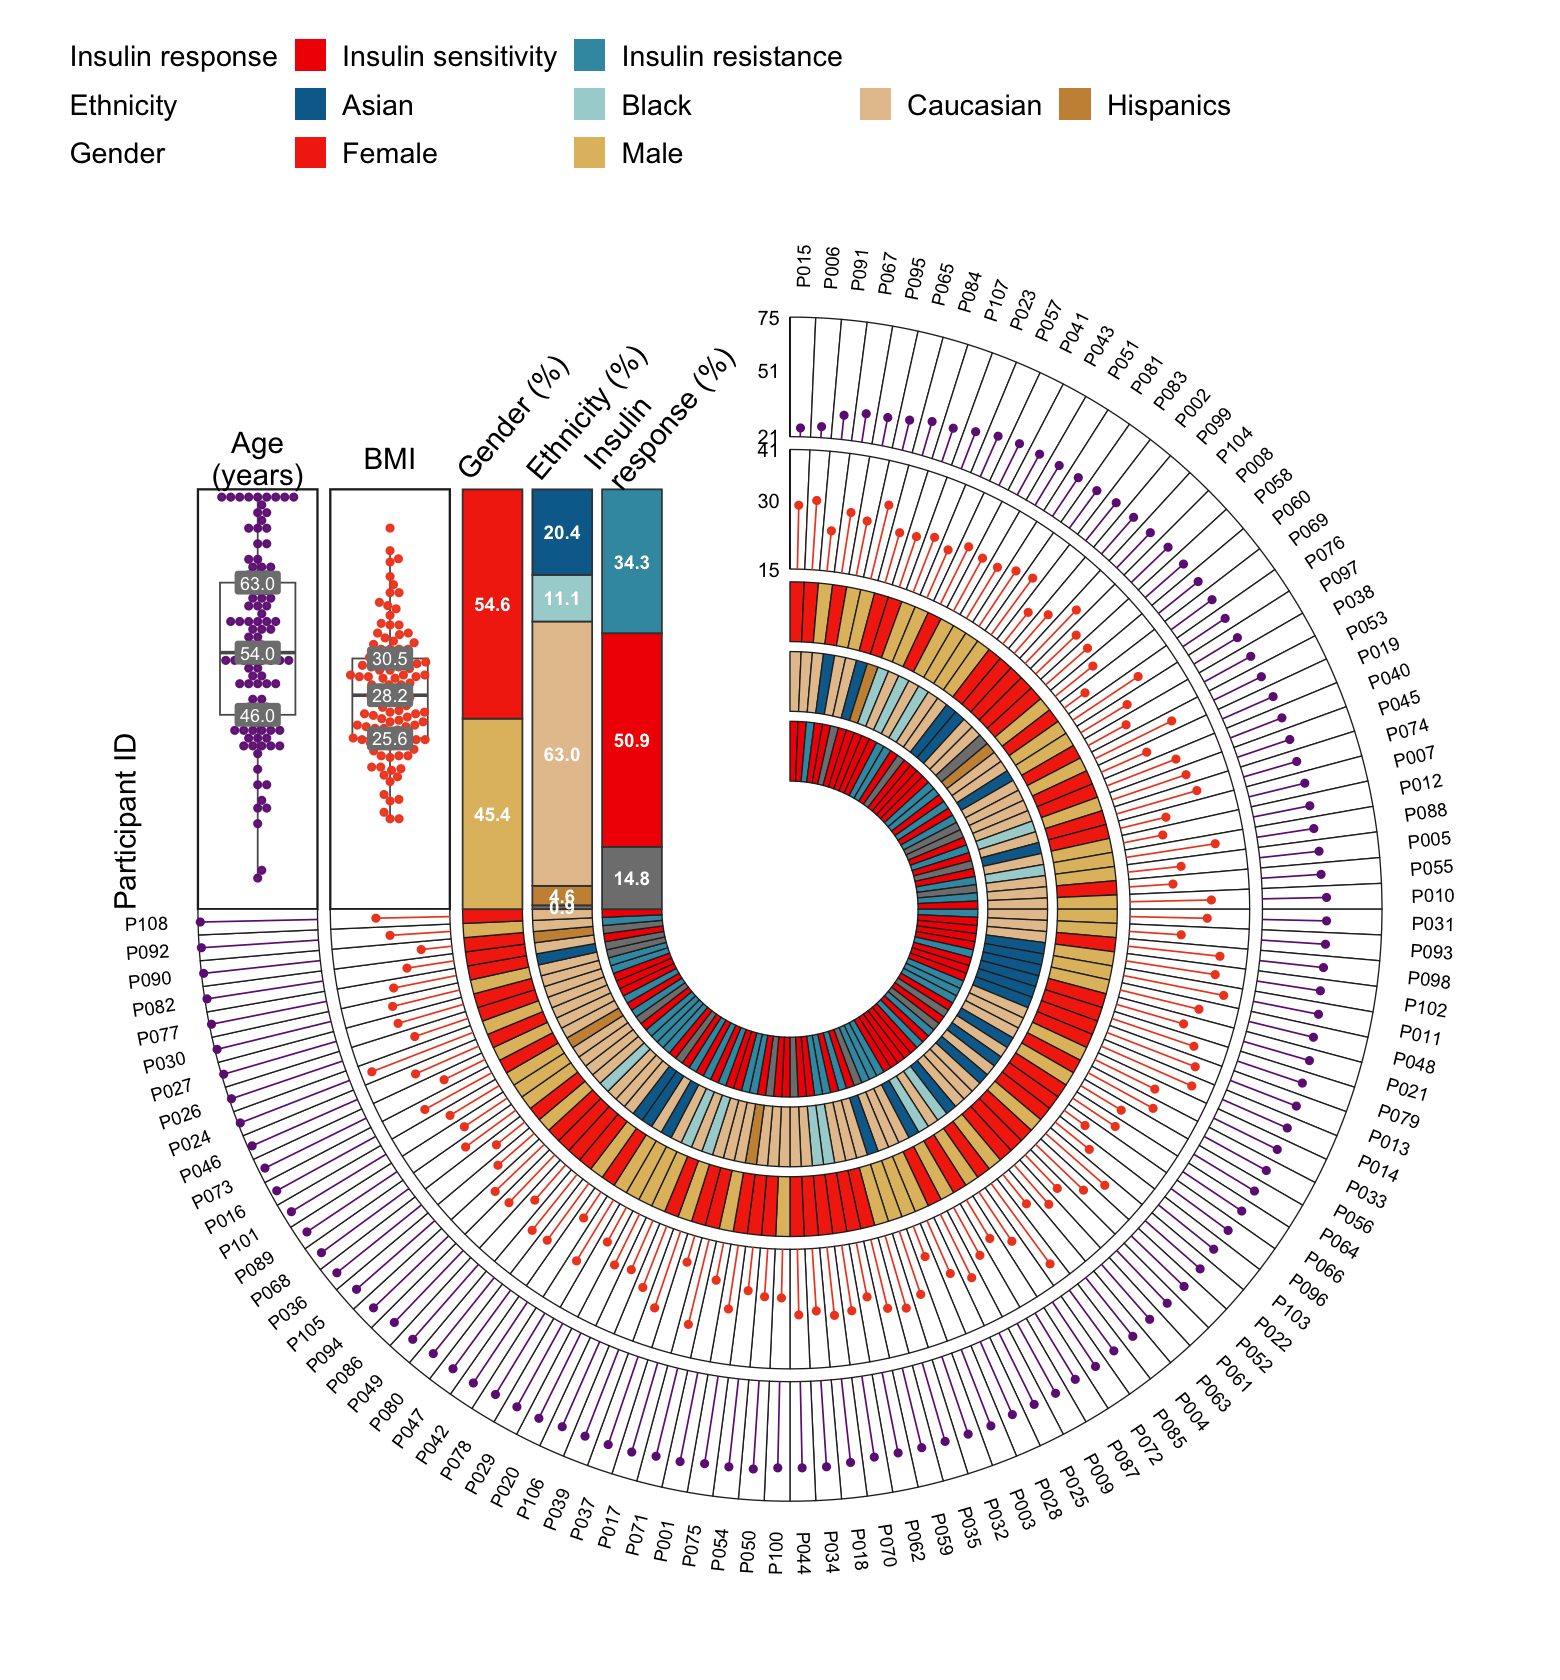
这个示例展示了一个模拟的 108 人队列。样本按年龄沿圆环排序(外缘标签);外侧两条棒棒糖轨道分别展示年龄与 BMI(圆点离圆心的距离 = 数值),内侧三条色带依次编码胰岛素反应、族裔与性别。左上方缺口处:每条连续轨道对应一块白色面板,内含箱线图、蜂群散点与三个四分位的灰色标签;每条分类轨道对应一条高高的 100% 堆叠比例柱,每个分段都标注百分比;两个数值轴(年龄 75 / 51 / 21、BMI 15 / 30 / 41)位于圆环中线位置,顶部图例为每条分类轨道单独占一行。
环境配置
系统要求:跨平台(Linux/MacOS/Windows)
编程语言:R
依赖包:
tidyverse;ggbeeswarm
数据准备
示例模拟了一个与参考图规模相当的队列(108 名参与者),使教程无需外部数据即可运行。每行一名参与者;age 与 bmi 为连续变量,iris、ethnicity 与 gender 为分类变量。
set.seed(2026)
n <- 108
dat <- tibble(
  id = sprintf("P%03d", 1:n),
  age = round(pmin(pmax(rnorm(n, 56, 12), 21), 74)),
  bmi = round(pmin(pmax(rnorm(n, 28, 4), 15), 41), 1),
  iris = sample(c("IS", "IR", "Unknown"), n, TRUE, prob = c(.52, .33, .15)),
  ethnicity = sample(c("Asian", "Black", "Caucasian", "Hispanics", "Unknown"), n, TRUE,
                     prob = c(.20, .07, .66, .04, .03)),
  gender = sample(c("Female", "Male"), n, TRUE, prob = c(.52, .48))
)

head(dat)
# A tibble: 6 × 6
id age bmi iris ethnicity gender
<chr> <dbl> <dbl> <chr> <chr> <chr>
1 P001 62 23.3 IR Caucasian Male
2 P002 43 23.8 IS Asian Female
3 P003 58 22.1 Unknown Caucasian Male
4 P004 55 23.2 IS Asian Male
5 P005 48 26.6 Unknown Caucasian Male
6 P006 26 30.1 IS Caucasian Female轨道布局以声明式方式描述。每条连续轨道定义其列名、占用的半径区间(inner/outer)、映射到该区间的数值范围(min/max)、轨道颜色与可选刻度值。每条分类轨道定义其列名与半径区间;颜色(及顺序)通过命名向量提供,未列出的分类会被自动配色。
numeric_tracks <- tribble(
  ~name,  ~column, ~title,          ~inner, ~outer, ~min, ~max, ~color,
  "Age",  "age",   "Age\n(years)",  3.32,   4.16,    21,   75,   "#702083",
  "BMI",  "bmi",   "BMI",           2.39,   3.23,    15,   41,   "#F04A22")

category_tracks <- tribble(
  ~name,               ~column,      ~title,                   ~inner, ~outer,
  "Insulin response",  "iris",       "Insulin\nresponse (%)",  0.90,   1.32,
  "Ethnicity",         "ethnicity",  "Ethnicity (%)",          1.39,   1.81,
  "Gender",            "gender",     "Gender (%)",             1.88,   2.30)

category_colors <- c(
  Female = "#F33010", Male = "#E2BD6E",
  Asian = "#046C9B", Black = "#A8D3D4", Caucasian = "#E5C39C", Hispanics = "#CA9143",
  Unknown = "#BDBDBD", IS = "#F21901", IR = "#3C99B0")

# Stacking order inside each proportion bar (bottom-to-top) and legend order
bar_order <- list(
  iris = c("Unknown", "IS", "IR"),
  ethnicity = c("Unknown", "Hispanics", "Caucasian", "Black", "Asian"),
  gender = c("Male", "Female"))
legend_order <- list(
  iris = c("IS", "IR"),
  ethnicity = c("Asian", "Black", "Caucasian", "Hispanics"),
  gender = c("Female", "Male"))

# Display names for short category codes, and the tick values of the axes
legend_labels <- c(IS = "Insulin sensitivity", IR = "Insulin resistance")
tick_values <- list(Age = c(21, 51, 75), BMI = c(15, 30, 41))
可视化
完整图形由一个可复用函数 circular_annotation_plot() 一次调用完成。它把每个样本扇区转换为普通笛卡尔坐标(圆环与汇总面板因此处于同一 ggplot2 坐标系中并严格对齐),随后依次叠加分类色带、棒棒糖轨道、样本标签、环形刻度与缺口面板。
circular_annotation_plot <- function(data, id_col, sort_col,
                                     numeric_tracks, category_tracks,
                                     category_order = list(), legend_order = list(),
                                     category_colors = c(), legend_labels = c(),
                                     tick_values = list(), panel_height = 2.95,
                                     gap_degrees = 90, font_scale = 1,
                                     show_summary = TRUE, show_unknown = FALSE) {
  for (column in category_tracks$column) {
    data[[column]] <- coalesce(na_if(as.character(data[[column]]), ""), "Unknown")
  }
  data <- data |>
    arrange(.data[[sort_col]]) |>
    mutate(.i = row_number(),
           .step = (360 - gap_degrees) * pi / 180 / n(),
           .start = pi / 2 - (.i - 1) * .step,
           .end = pi / 2 - .i * .step,
           .angle = (.start + .end) / 2)

  sector_polygons <- function(inner, outer) {
    map_dfr(seq_len(nrow(data)), function(i) {
      a <- seq(data$.start[i], data$.end[i], length.out = 10)
      tibble(.i = i,
             x = c(outer * cos(a), inner * cos(rev(a))),
             y = c(outer * sin(a), inner * sin(rev(a))))
    })
  }
  numeric_rings <- map_dfr(seq_len(nrow(numeric_tracks)), function(i) {
    tb <- numeric_tracks[i, ]
    sector_polygons(tb$inner, tb$outer) |> mutate(.track = tb$name)
  })
  category_rings <- map_dfr(seq_len(nrow(category_tracks)), function(i) {
    tb <- category_tracks[i, ]
    sector_polygons(tb$inner, tb$outer) |>
      mutate(.track = tb$name, value = data[[tb$column]][.i])
  })

  all_values <- unique(category_rings$value)
  missing_values <- setdiff(all_values, names(category_colors))
  if (length(missing_values) > 0) {
    category_colors <- c(category_colors,
      rlang::set_names(scales::hue_pal()(length(missing_values)), missing_values))
  }
  key_colors <- category_rings |>
    distinct(.track, value) |>
    mutate(key = paste(.track, value, sep = "::"), color = unname(category_colors[value]))
  key_pal <- rlang::set_names(key_colors$color, key_colors$key)

  lollipops <- map_dfr(seq_len(nrow(numeric_tracks)), function(i) {
    tb <- numeric_tracks[i, ]
    r <- scales::rescale(data[[tb$column]], to = c(tb$inner, tb$outer), from = c(tb$min, tb$max))
    tibble(.track = tb$name,
           x0 = tb$inner * cos(data$.angle), y0 = tb$inner * sin(data$.angle),
           x1 = r * cos(data$.angle), y1 = r * sin(data$.angle))
  })

  # gap summary: numeric points/quartiles
  numeric_points <- map_dfr(seq_len(nrow(numeric_tracks)), function(i) {
    tb <- numeric_tracks[i, ]
    tibble(.track = tb$name, x = -(tb$inner + tb$outer) / 2,
           y = scales::rescale(data[[tb$column]], to = c(0, panel_height), from = c(tb$min, tb$max)))
  })
  quartiles <- map_dfr(seq_len(nrow(numeric_tracks)), function(i) {
    tb <- numeric_tracks[i, ]
    q <- quantile(data[[tb$column]], c(.25, .5, .75))
    tibble(x = rep(-(tb$inner + tb$outer) / 2, 3),
           y = scales::rescale(q, to = c(0, panel_height), from = c(tb$min, tb$max)),
           label = sprintf("%.1f", q))
  })
  panel_boxes <- numeric_tracks |>
    transmute(xmin = -outer, xmax = -inner, ymin = 0, ymax = panel_height, .track = name)

  bars <- map_dfr(seq_len(nrow(category_tracks)), function(i) {
    tb <- category_tracks[i, ]
    observed <- unique(data[[tb$column]])
    preferred <- category_order[[tb$column]]
    if (is.null(preferred)) preferred <- character()
    lv <- c(preferred[preferred %in% observed], sort(setdiff(observed, preferred)))
    tibble(value = factor(data[[tb$column]], levels = lv)) |>
      count(value, .drop = FALSE) |>
      mutate(fraction = n / sum(n),
             ymin = lag(cumsum(fraction * panel_height), default = 0),
             ymax = cumsum(fraction * panel_height),
             xmin = -tb$outer, xmax = -tb$inner,
             x = -(tb$inner + tb$outer) / 2, y = (ymin + ymax) / 2,
             .track = tb$name, key = paste(.track, value, sep = "::"))
  })

  outer_radius <- max(numeric_tracks$outer, category_tracks$outer) + 0.21
  sample_labels <- data |>
    mutate(x = outer_radius * cos(.angle), y = outer_radius * sin(.angle),
           text_angle = .angle * 180 / pi,
           flip = text_angle < -90,
           text_angle = if_else(flip, text_angle + 180, text_angle),
           hjust = if_else(flip, 1, 0))

  panel_titles <- bind_rows(
    numeric_tracks |> transmute(x = -(inner + outer) / 2, y = panel_height + .22,
                                label = title, angle = 0, hjust = .5),
    if (show_summary) category_tracks |> transmute(x = -outer, y = panel_height + .10,
                                label = title, angle = 50, hjust = 0))

  axis_labels <- map_dfr(seq_len(nrow(numeric_tracks)), function(i) {
    tb <- numeric_tracks[i, ]
    v <- tick_values[[tb$name]]
    if (is.null(v)) v <- round(seq(tb$min, tb$max, length.out = 3))
    tibble(label = v, y = scales::rescale(v, to = c(tb$inner, tb$outer), from = c(tb$min, tb$max)))
  })
  axis_lines <- numeric_tracks |> transmute(x = 0, xend = 0, y = inner, yend = outer)

  # legend table: one row per category track (header + items + spacers)
  legend_items <- map_dfr(seq_len(nrow(category_tracks)), function(i) {
    tb <- category_tracks[i, ]
    observed <- unique(data[[tb$column]])
    preferred <- legend_order[[tb$column]]
    if (is.null(preferred)) preferred <- character()
    ord <- c(preferred[preferred %in% observed], sort(setdiff(observed, preferred)))
    tibble(.track = tb$name, .track_no = i, value = ord,
           key = paste(.track, ord, sep = "::"))
  })
  if (!show_unknown) legend_items <- filter(legend_items, value != "Unknown")
  legend_items <- legend_items |> mutate(label = value)
  if (length(legend_labels) > 0) {
    hit <- legend_items$value %in% names(legend_labels)
    legend_items$label[hit] <- unname(legend_labels[legend_items$value[hit]])
  }
  legend_cols <- max(count(legend_items, .track_no)$n) + 1
  legend_table <- map_dfr(seq_len(nrow(category_tracks)), function(i) {
    tb <- category_tracks[i, ]
    items <- filter(legend_items, .track_no == i) |>
      transmute(.track_no, .track, value, key, label)
    hdr <- tibble(.track_no = i, .track = tb$name, value = NA_character_,
                  key = paste0(".h", i), label = tb$name)
    pad <- tibble(.track_no = rep(i, legend_cols - nrow(items) - 1),
                  .track = tb$name, value = NA_character_,
                  key = paste0(".s", i, "_", seq_len(legend_cols - nrow(items) - 1)), label = "")
    bind_rows(hdr, items, pad)
  })
  transparent <- legend_table$key[is.na(legend_table$value)]
  legend_pal <- c(key_pal, rlang::set_names(rep("#00000000", length(transparent)), transparent))

  p <- ggplot() +
    if (show_summary) geom_rect(data = panel_boxes, aes(xmin = xmin, xmax = xmax, ymin = ymin, ymax = ymax),
        fill = "white", colour = "grey15", linewidth = .52) else NULL
  p <- p +
    geom_polygon(data = numeric_rings, aes(x, y, group = interaction(.track, .i)),
                 fill = "white", colour = "grey15", linewidth = .30) +
    geom_polygon(data = category_rings, aes(x, y, group = interaction(.track, .i), fill = paste(.track, value, sep = "::")),
                 colour = "grey15", linewidth = .30) +
    scale_fill_manual(values = legend_pal,
                      limits = legend_table$key, breaks = legend_table$key,
                      labels = legend_table$label, name = NULL, drop = FALSE,
                      guide = guide_legend(nrow = nrow(category_tracks), byrow = TRUE,
                                           override.aes = list(colour = NA))) +
    geom_segment(data = lollipops, aes(x0, y0, xend = x1, yend = y1),
                 colour = lollipops$.track |> map_chr(~ numeric_tracks$color[numeric_tracks$name == .x]), linewidth = .38) +
    geom_point(data = lollipops, aes(x1, y1),
               colour = lollipops$.track |> map_chr(~ numeric_tracks$color[numeric_tracks$name == .x]), size = 1.15) +
    geom_text(data = sample_labels, aes(x, y, label = .data[[id_col]], angle = text_angle, hjust = hjust),
              size = 2.5 * font_scale) +
    if (show_summary) geom_boxplot(data = numeric_points, aes(x, y, group = .track),
        width = .53, outlier.shape = NA, fill = "white", colour = "grey35", linewidth = .40) else NULL
  p <- p +
    { if (show_summary) geom_beeswarm(data = numeric_points, aes(x, y, colour = .track, group = .track),
                  cex = 0.7, size = 1.15, alpha = .95, show.legend = FALSE) } +
    scale_colour_manual(values = rlang::set_names(numeric_tracks$color, numeric_tracks$name), guide = "none") +
    { if (show_summary) geom_label(data = quartiles, aes(x, y, label = label), fill = "grey50", colour = "white",
               linewidth = 0, size = 2.45 * font_scale) } +
    { if (show_summary) geom_rect(data = bars, aes(xmin = xmin, xmax = xmax, ymin = ymin, ymax = ymax, fill = key), colour = "grey25", linewidth = .40) } +
    { if (show_summary) geom_text(data = bars, aes(x, y, label = sprintf("%.1f", 100 * fraction)),
              colour = "white", fontface = "bold", size = 2.55 * font_scale) } +
    { if (show_summary) geom_segment(data = axis_lines, aes(x, y, xend = xend, yend = yend), linewidth = .34) } +
    { if (show_summary) geom_text(data = axis_labels, aes(x = -.07, y, label = label), hjust = 1, size = 2.7 * font_scale) } +
    { if (show_summary) geom_text(data = panel_titles, aes(x, y, label = label, angle = angle, hjust = hjust),
              lineheight = .88, size = 4 * font_scale) } +
    { if (show_summary) annotate("text", x = -max(numeric_tracks$outer) - .51, y = .62, label = "Participant ID",
             angle = 90, size = 4 * font_scale) } +
    coord_fixed(xlim = c(-outer_radius - .55, outer_radius + .41),
                ylim = c(-outer_radius - .31, outer_radius + .28), ratio = 1, clip = "off") +
    theme_void(base_size = 12 * font_scale) +
    theme(plot.margin = margin(8, 10, 8, 10), legend.position = "top",
          legend.justification = "left",
          legend.text = element_text(size = 11 * font_scale),
          legend.key.size = grid::unit(.45 * font_scale, "cm"))
  p
}
1. 基础环形图
将 show_summary = FALSE 即可只绘制圆环本身:排序后的样本、分类色带、棒棒糖数值轨道、外缘样本标签与分类图例。
p1 <- circular_annotation_plot(dat, id_col = "id", sort_col = "age",
  numeric_tracks = numeric_tracks, category_tracks = category_tracks,
  category_colors = category_colors, show_summary = FALSE)
p1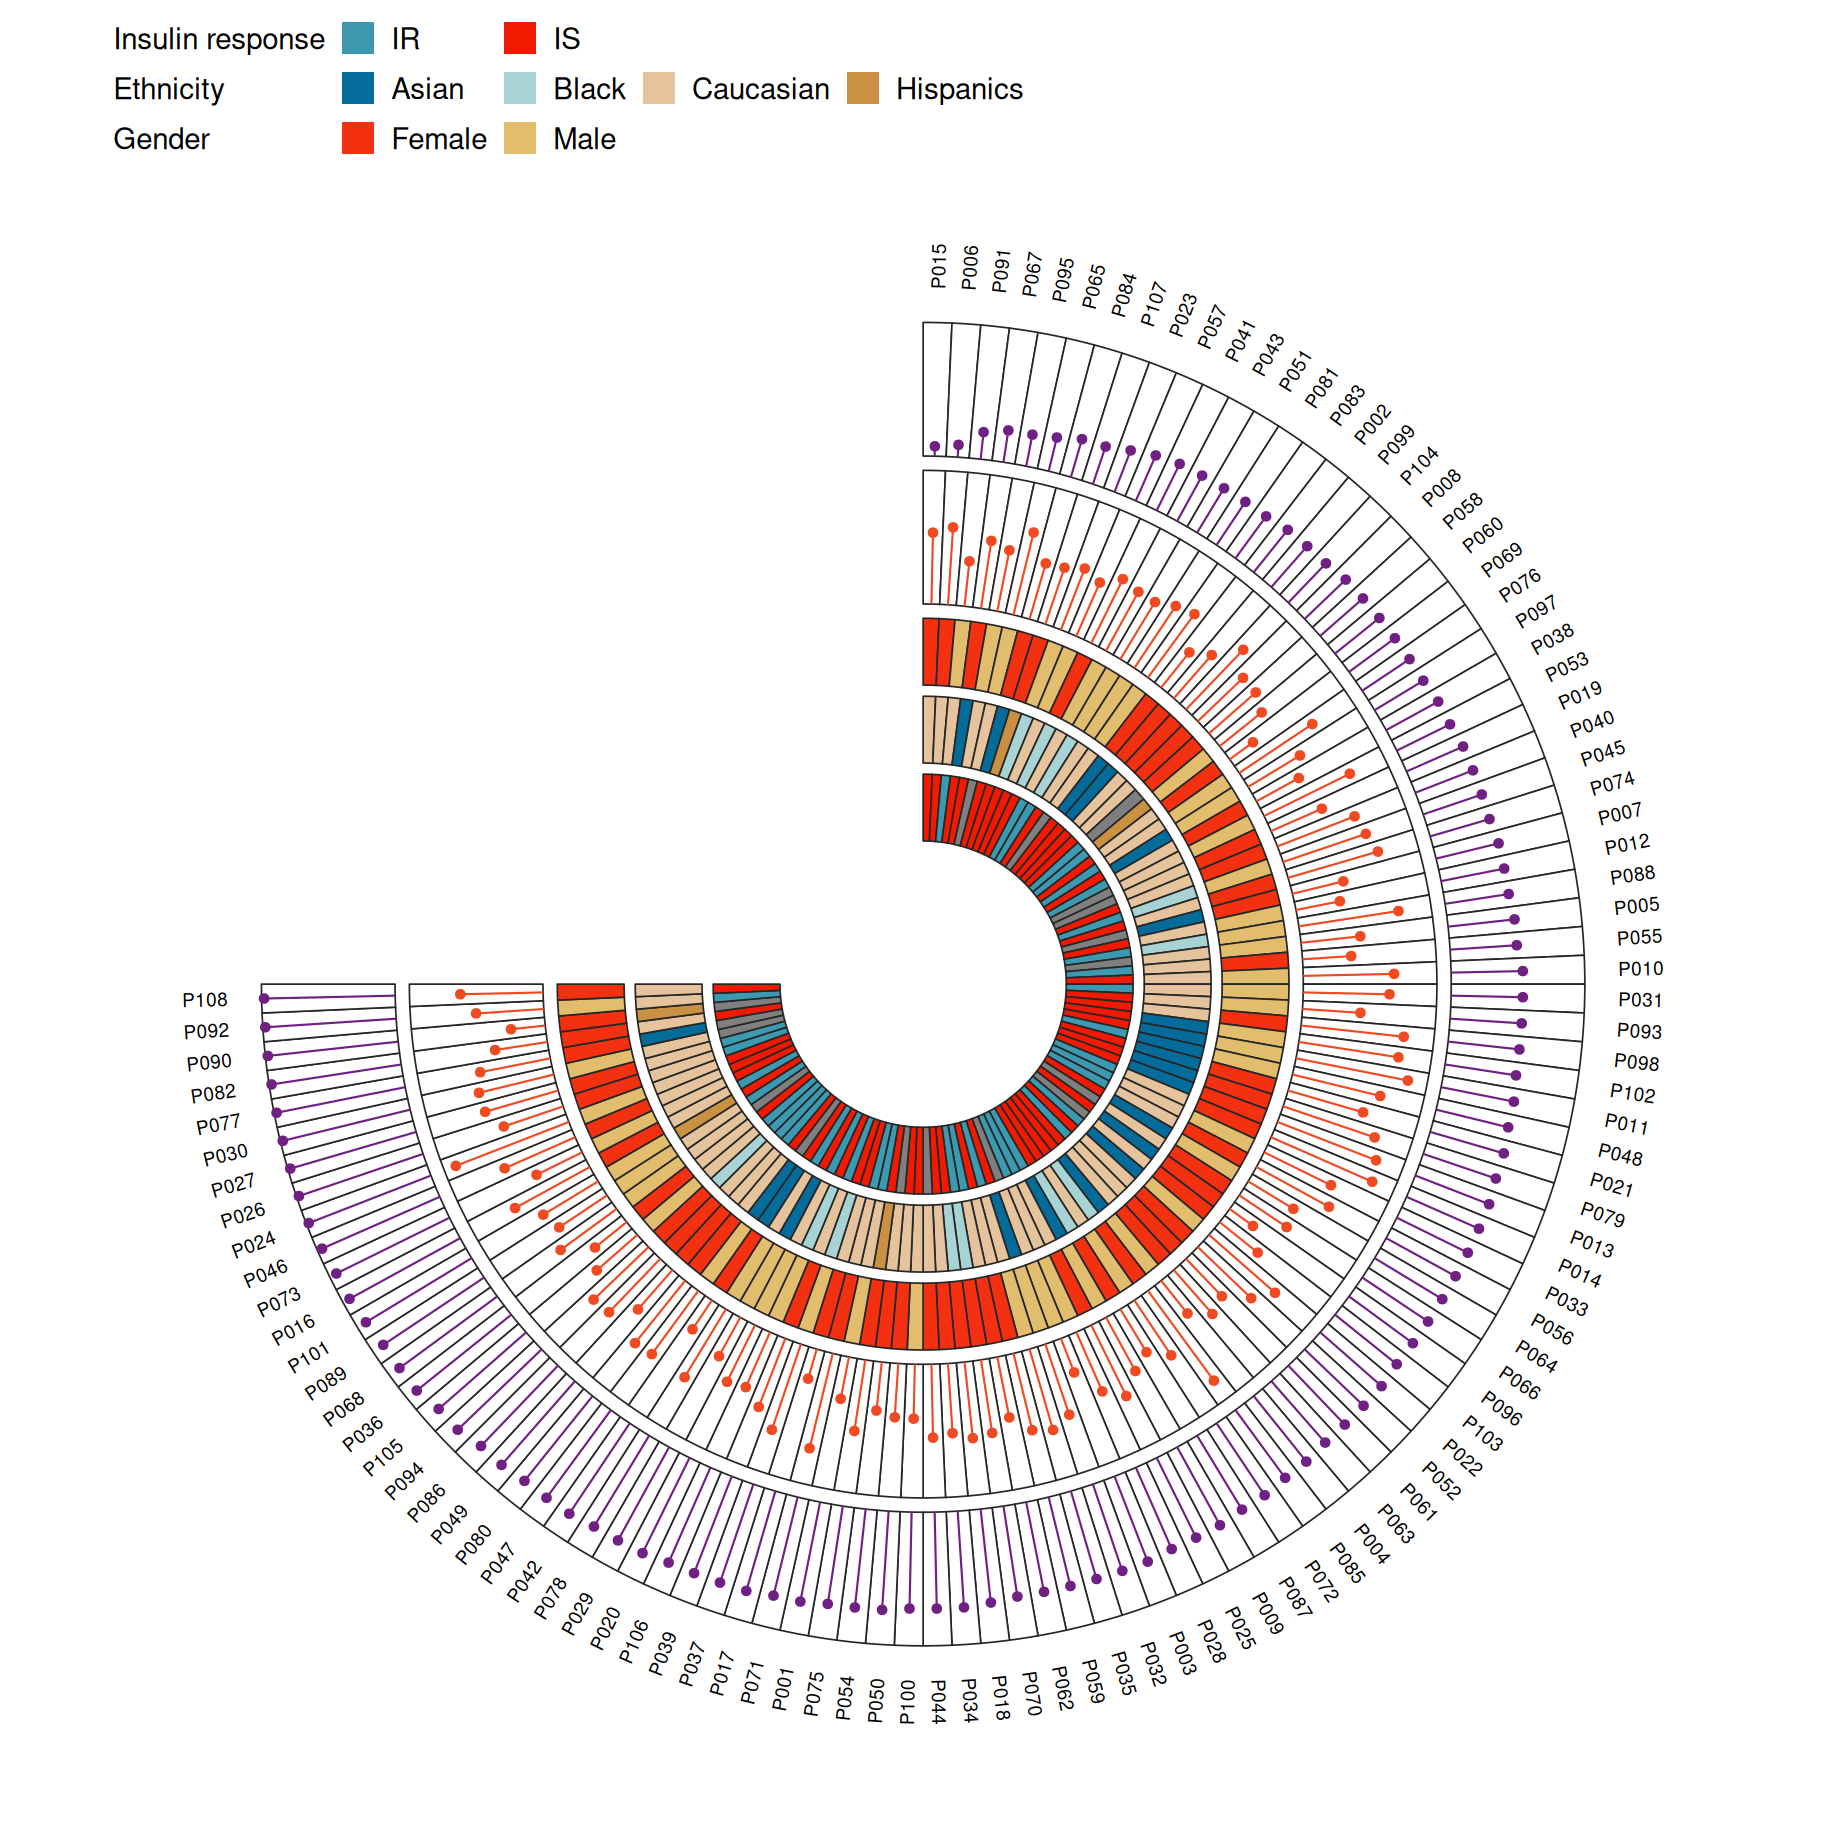
2. 缺口处的汇总面板
默认 show_summary = TRUE 时,圆环缺口处会填充队列汇总:每条连续轨道对应一块白色面板(箱线图、蜂群散点、四分位标签),每条分类轨道对应一条高高的 100% 堆叠比例柱,并在中线位置绘制数值轴——即上方示例图的完整布局。
p2 <- circular_annotation_plot(dat, id_col = "id", sort_col = "age",
  numeric_tracks = numeric_tracks, category_tracks = category_tracks,
  category_order = bar_order, legend_order = legend_order,
  category_colors = category_colors, legend_labels = legend_labels,
  tick_values = tick_values, font_scale = 1.25)
p2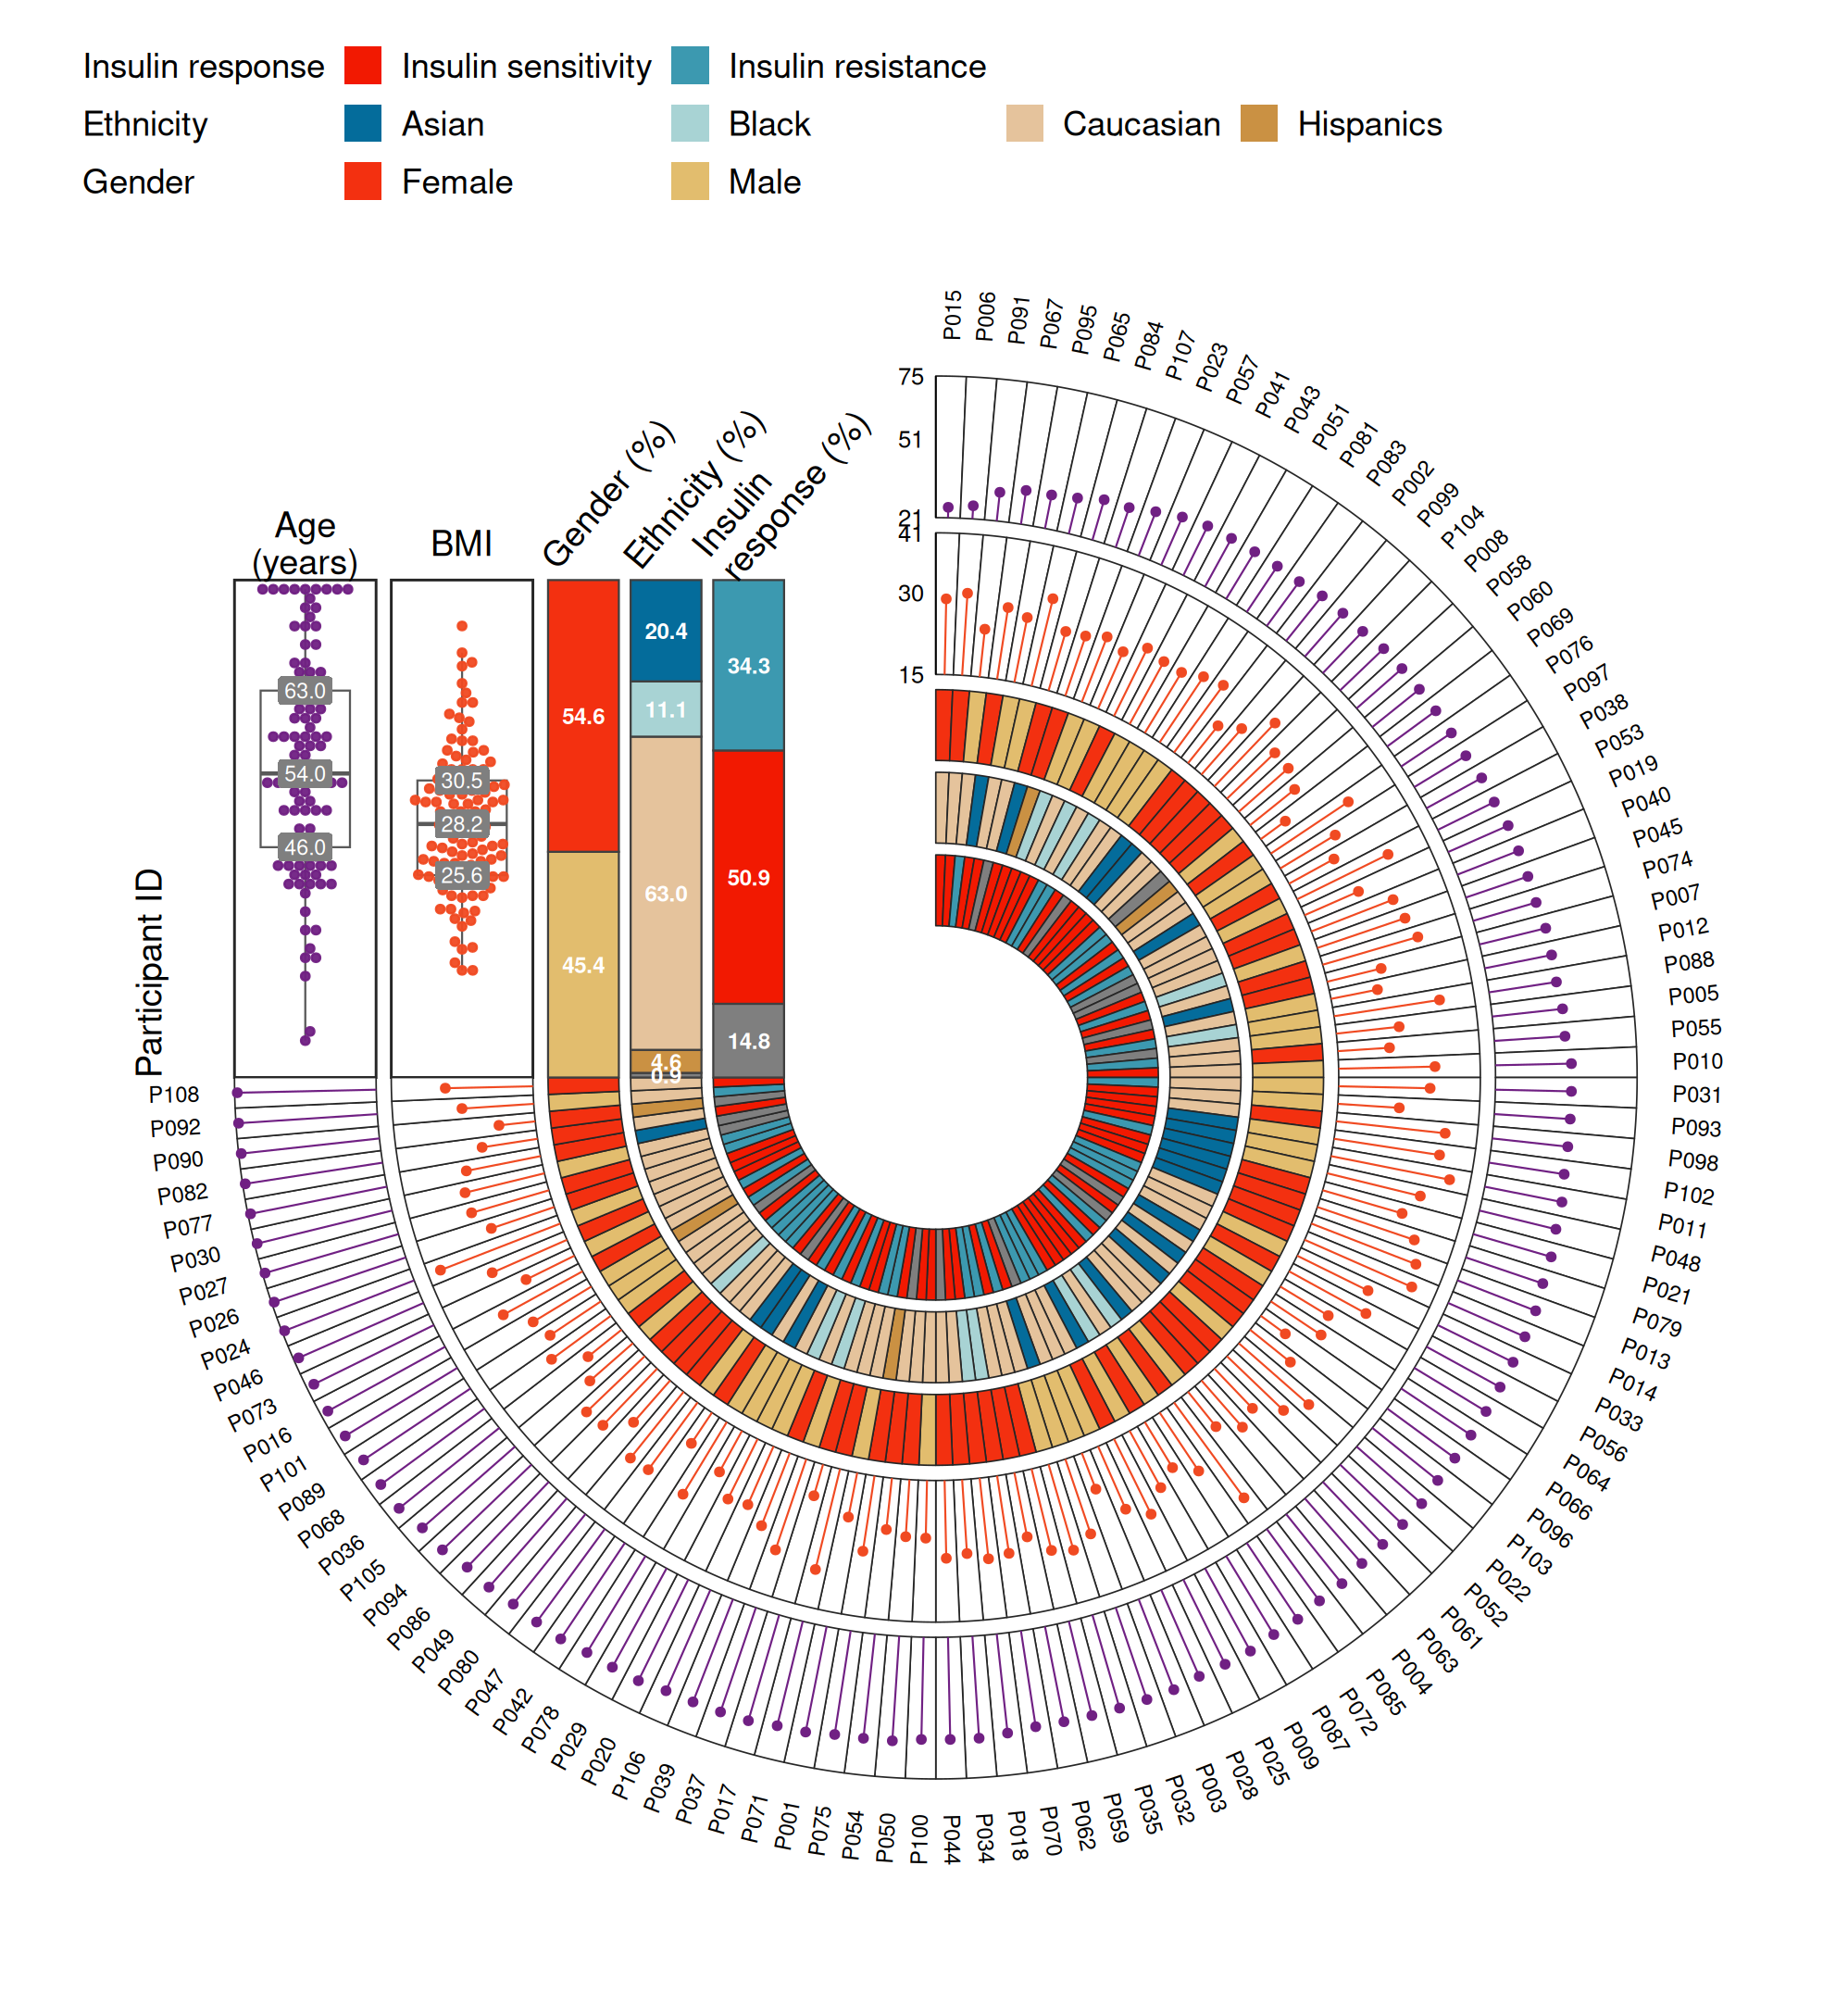
提示
关键参数:
-
sort_col:决定样本沿圆环排序的列(升序)。 -
panel_height:缺口内所有汇总面板的统一高度(默认2.95)。 -
gap_degrees:承载汇总面板的缺口角大小(默认 90°)。 -
tick_values:数值轴刻度值的命名列表,如list(Age = c(21, 51, 75))。 -
category_order/legend_order:比例柱内部自下而上的堆叠顺序与图例顺序。 -
legend_labels:短代码的展示名映射(如IS→ “Insulin sensitivity”);show_unknown控制图例是否隐藏Unknown类。 -
show_summary/font_scale:绘制缺口面板(TRUE)或仅圆环(FALSE);全局文字缩放。
3. 自定义
轨道表与函数参数让图形易于改换目标:这里把同一队列改按 BMI 排序,并把缺口加宽到 120°。
p3 <- circular_annotation_plot(dat, id_col = "id", sort_col = "bmi",
  numeric_tracks = numeric_tracks, category_tracks = category_tracks,
  category_order = bar_order, legend_order = legend_order,
  category_colors = category_colors, legend_labels = legend_labels,
  tick_values = tick_values, font_scale = 1.25, gap_degrees = 120)
p3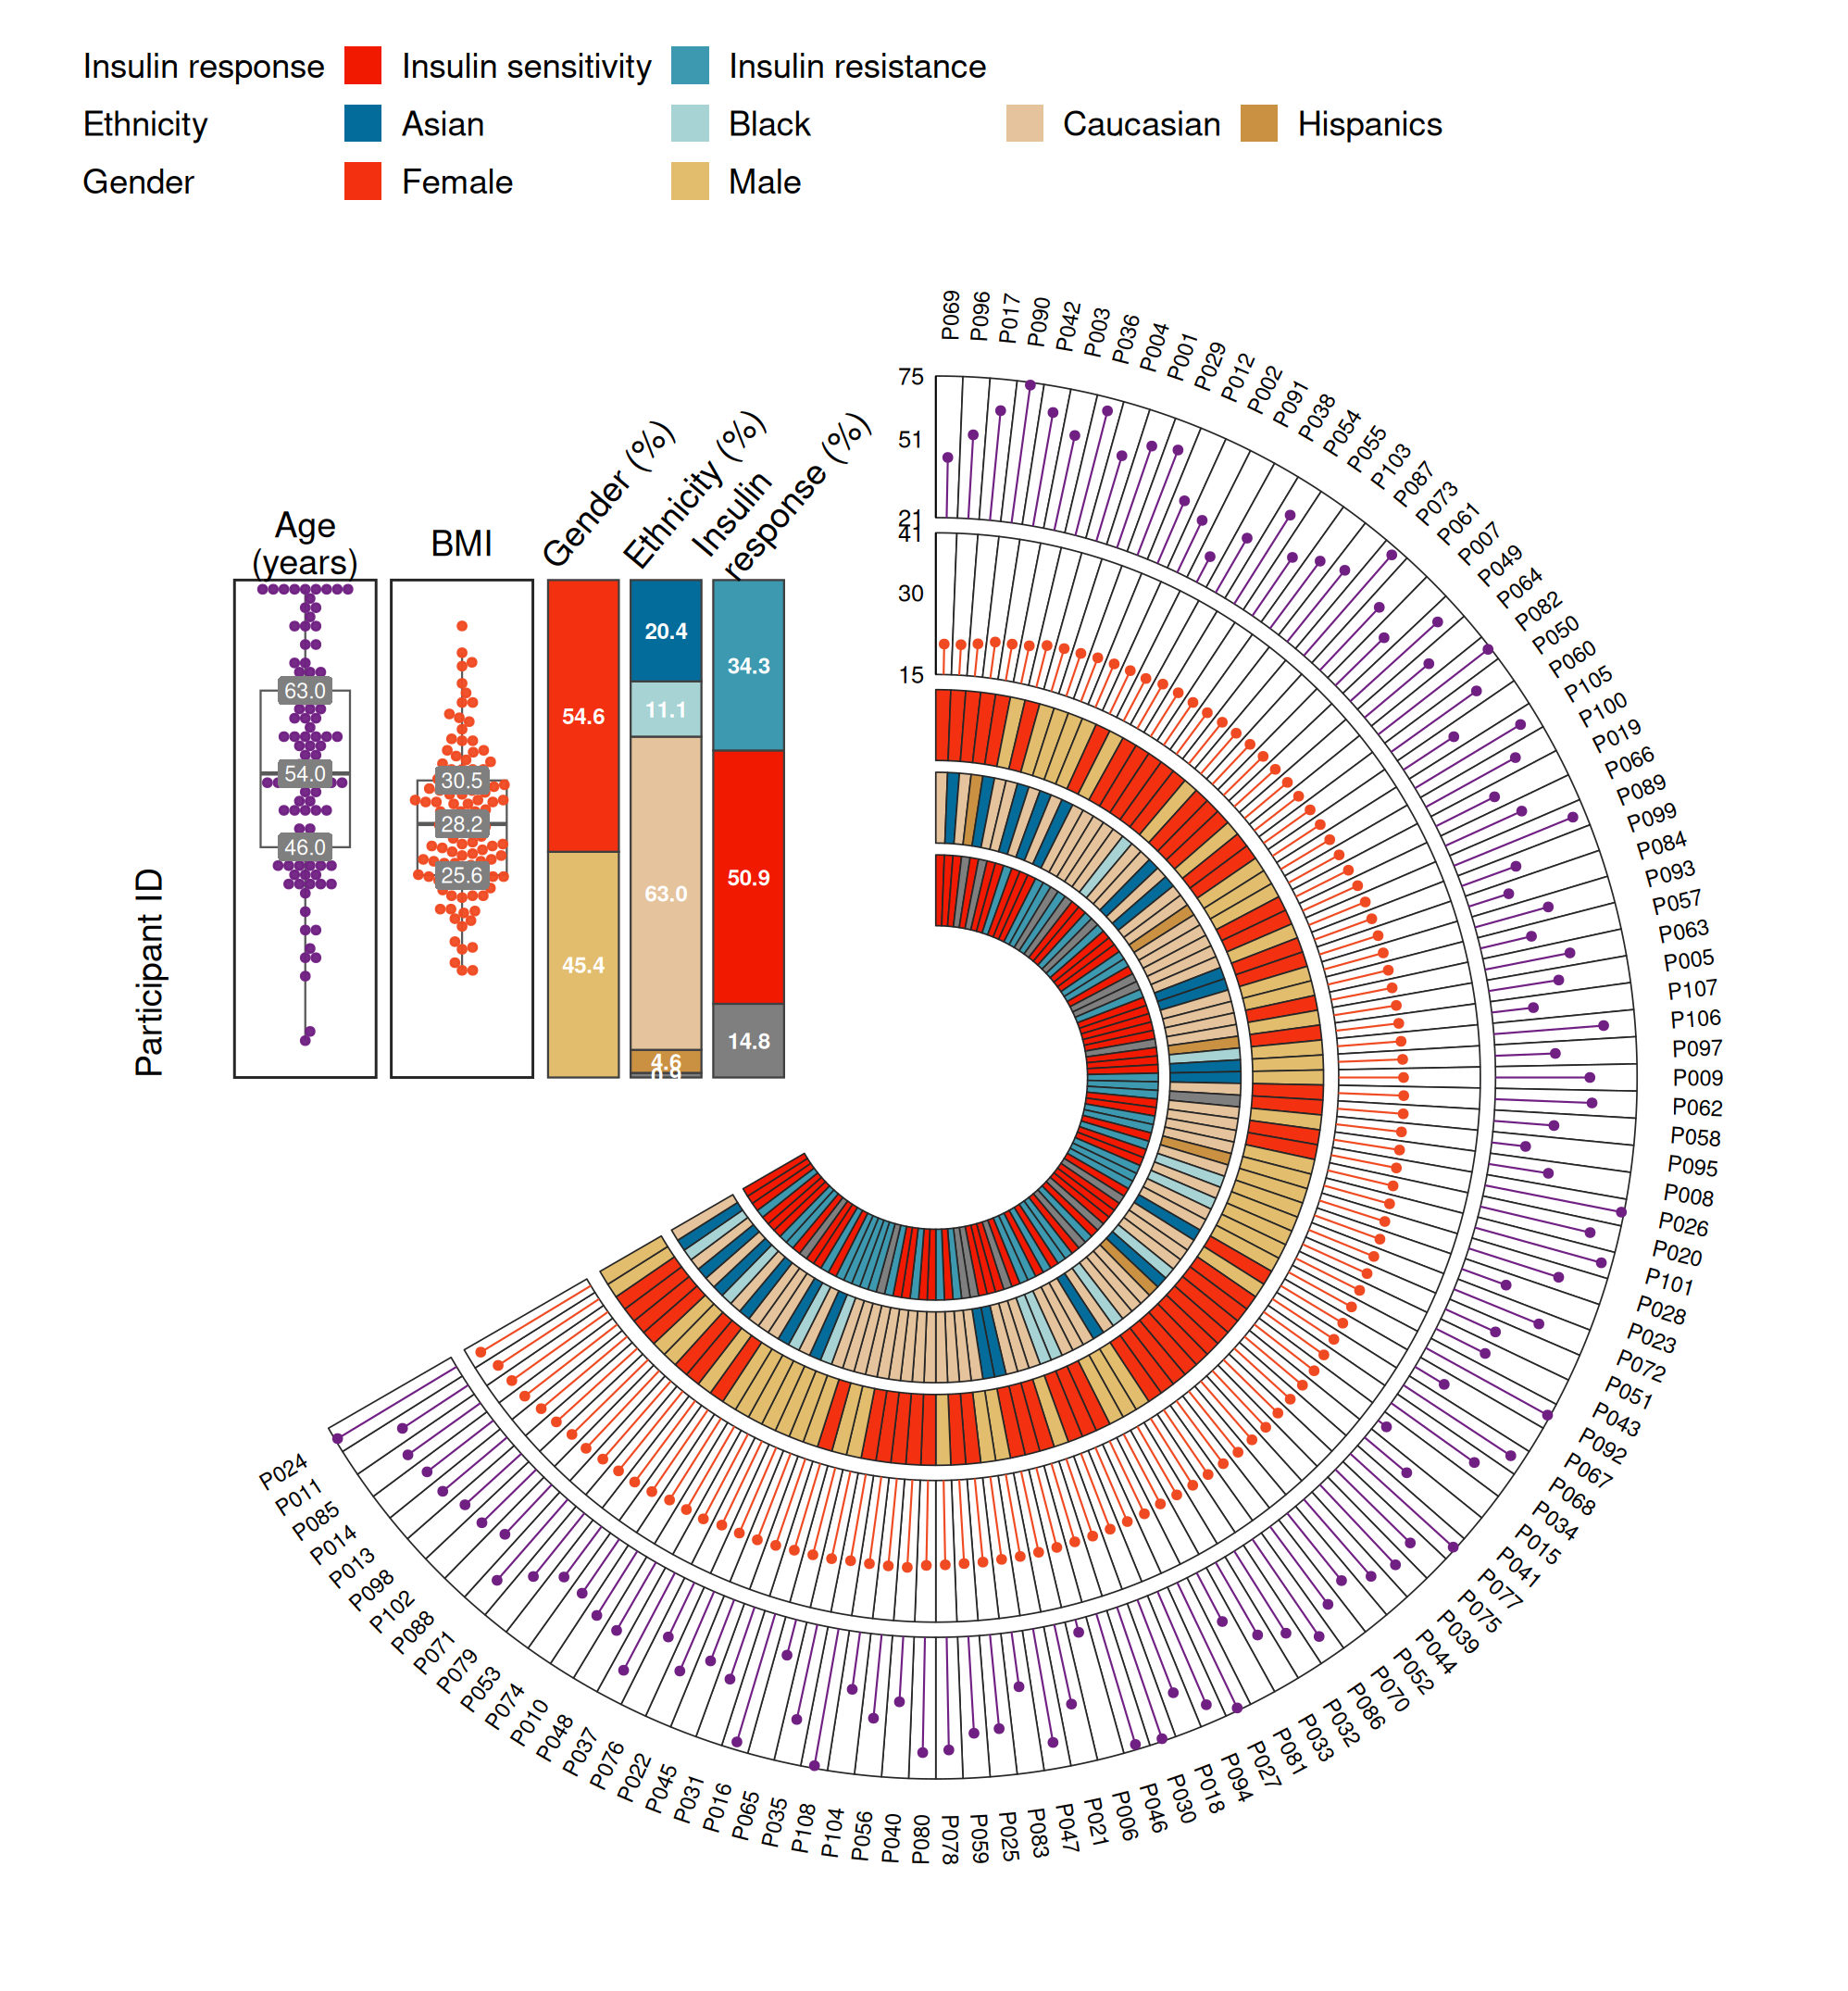
应用场景
- 队列概览图:多组学与纵向研究开篇图中的参与者特征(人口统计、临床变量、组学分组)——参考论文正是使用这一布局。
- 临床试验臂:样本按生物标志物或入组顺序排序,轨道编码治疗臂、响应与关键测量值。
- 单细胞 / 样本级质控:以连续轨道展示每个样本的质量指标,缺口处给出总体分布。
- 声明式轨道表意味着新增变量只需追加一行;版式引擎(扇区角度、半径映射、面板对齐)保持不变。
参考文献
[1] 顶刊图社 | 第094期:环形多轨道样本注释图. 微信公众号文章. https://mp.weixin.qq.com/s/E2IZKV3eCi9ufdsGOAeE8g
[2] Shen X, Wang C, Zhou X, et al. Nonlinear dynamics of multi-omics profiles during human aging. Nat Aging. 2024;4(11):1619-1634. doi:10.1038/s43587-024-00692-2