# 加载包
library(ggplot2)
library(dplyr)ECDF 图
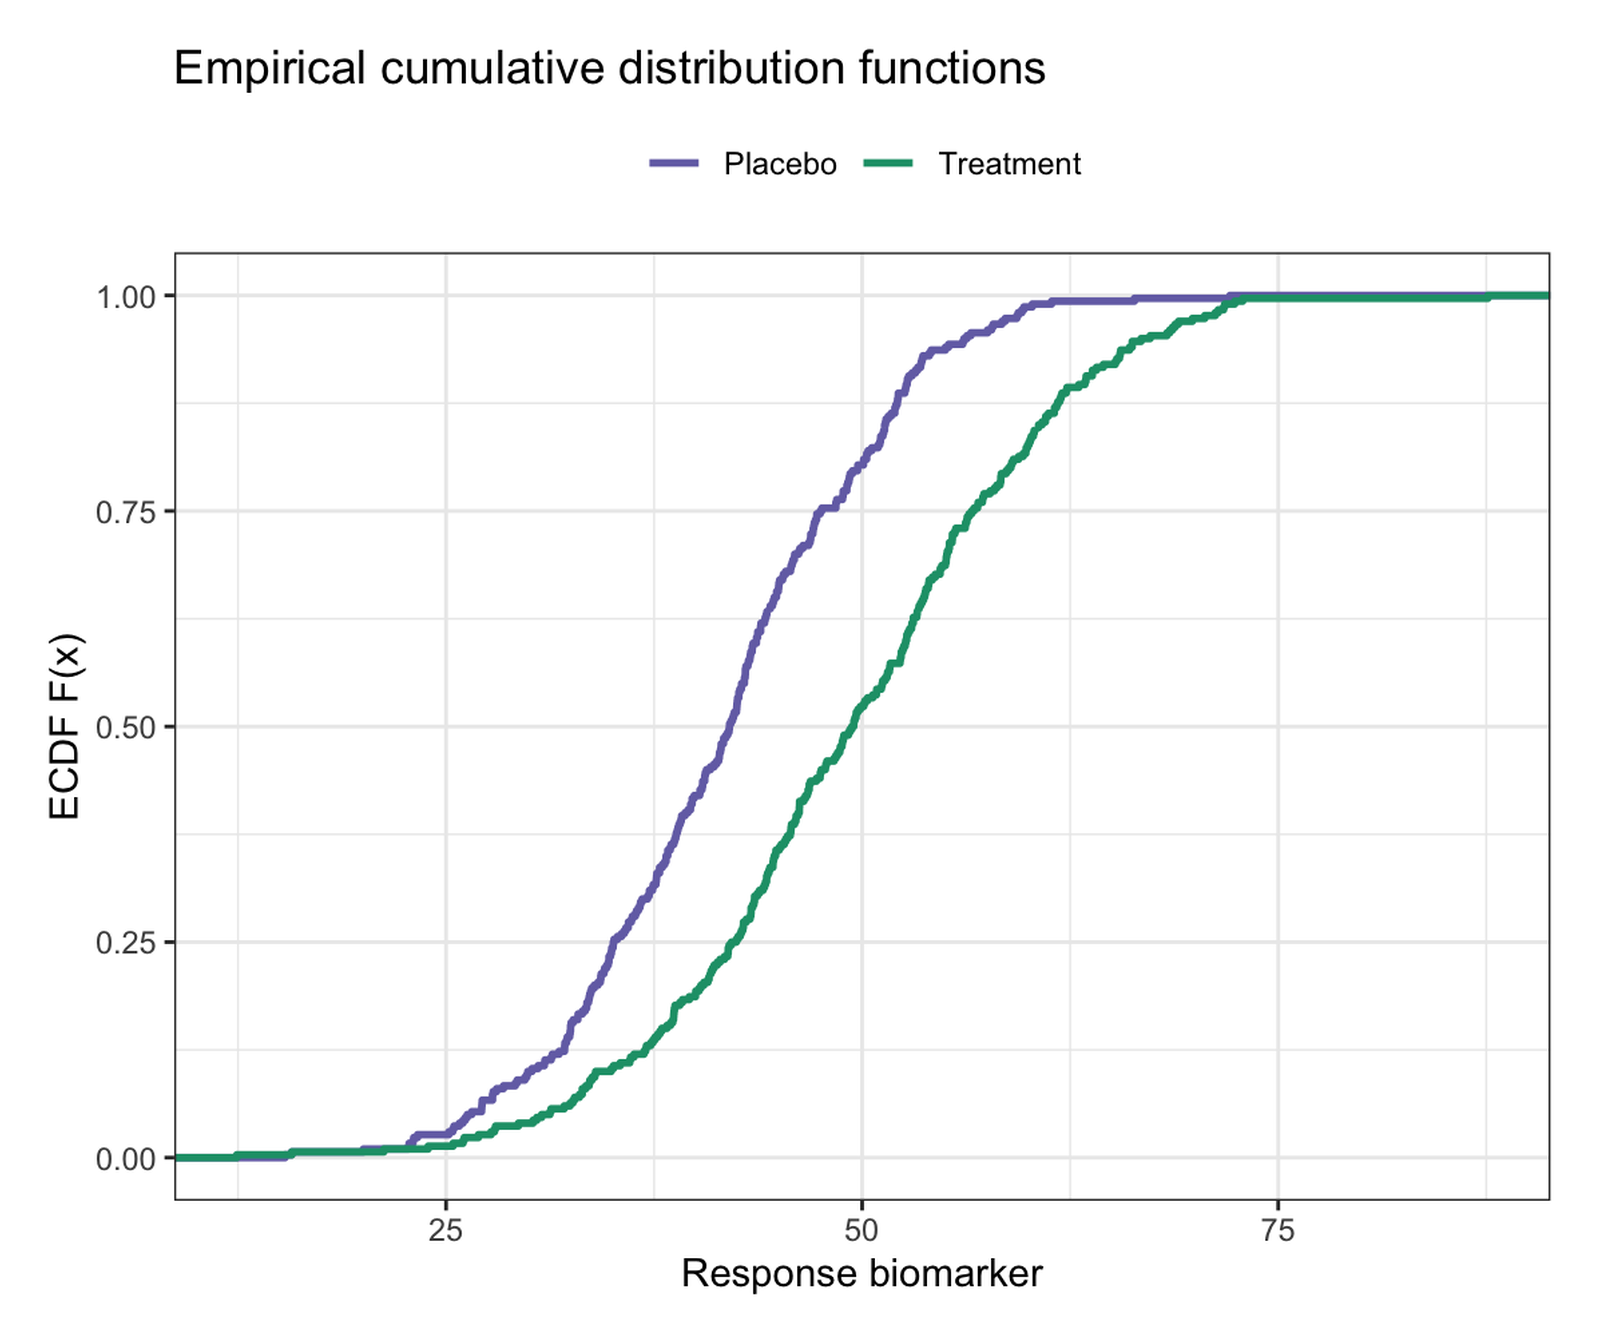
经验累积分布函数(ECDF),\(F_n(x) = \frac{1}{n}\sum_i \mathbf{1}(x_i \le x)\),把每个观测画成一段从 0 爬升到 1 的阶梯——一个完整、无假设的分布画像。与直方图相比,它不需要调分箱宽度、显示每个数据点的位置,且分位数可直接读图:组中位数就是曲线穿过 0.5 的位置 [1]。把两条 ECDF 画在同一坐标系里,也是两样本 Kolmogorov–Smirnov 检验的几何基础——两条曲线间的垂直间距就是 KS 统计量 [2]。
本教程涵盖四种工作流:
-
stat_ecdf()的两组 ECDF; - 多组 ECDF 与中位数标注;
- 两样本 ECDF差值图——KS 统计量的可视化;
- p 值 ECDF——组学质控的标准视图。
Example
Setup
系统要求:跨平台(Linux/MacOS/Windows)
编程语言:R
依赖包:
ggplot2;dplyr
sessioninfo::session_info("attached")─ Session info ───────────────────────────────────────────────────────────────
setting value
version R version 4.6.2 (2026-10-29)
os Ubuntu 24.04.5 LTS
system x86_64, linux-gnu
ui X11
language (EN)
collate C.UTF-8
ctype C.UTF-8
tz UTC
date 2026-10-31
pandoc 3.1.3 @ /usr/bin/ (via rmarkdown)
quarto 1.10.20 @ /usr/local/bin/quarto
─ Packages ───────────────────────────────────────────────────────────────────
! package * version date (UTC) lib source
P dplyr * 1.2.1 2026-04-03 [?] RSPM
P ggplot2 * 4.0.3.9000 2026-10-30 [?] Github (tidyverse/ggplot2@b638d65)
[1] /home/runner/.cache/R/renv/library/Bizard-5140bdc6/linux-ubuntu-noble/R-4.6/x86_64-pc-linux-gnu
[2] /home/runner/work/_temp/Library
[3] /opt/R/4.6.2/lib/R/library
* ── Packages attached to the search path.
P ── Loaded and on-disk path mismatch.
──────────────────────────────────────────────────────────────────────────────Data Preparation
两个固定种子的数据集:两手臂生物标志物研究(Placebo 与 Treatment 各 n = 300)与三基因表达比较;另有 2,000 个零假设下模拟的 p 值与混入真实信号的 p 值,用于质控视图。
set.seed(251)

resp <- data.frame(
  value = c(rnorm(300, 42, 9), rnorm(300, 49, 11)),
  group = rep(c("Placebo", "Treatment"), each = 300))

set.seed(42)
expr3 <- data.frame(
  expr = c(rnorm(200, 6, 1.4), rnorm(200, 5.4, 1.6), rnorm(200, 4.6, 1.2)),
  gene = rep(c("HER2", "EGFR", "KRAS"), each = 200))

pv_null <- runif(2000)
pv_mix  <- c(runif(1800), 10^(-rnorm(200, 2.4, 0.5)))
pvdf <- data.frame(p = c(pv_null, pv_mix),
                   what = rep(c("Null p-values", "With true signals"), each = 2000))
Visualization
1. 两组 ECDF
ggplot(resp, aes(value, colour = group)) +
  stat_ecdf(geom = "step", linewidth = 1) +
  scale_color_manual(values = c(Placebo = "#7570B3", Treatment = "#1B9E77"),
                     name = NULL) +
  labs(x = "Response biomarker", y = "ECDF F(x)",
       title = "Empirical cumulative distribution functions") +
  theme_bw(base_size = 11) +
  theme(legend.position = "top")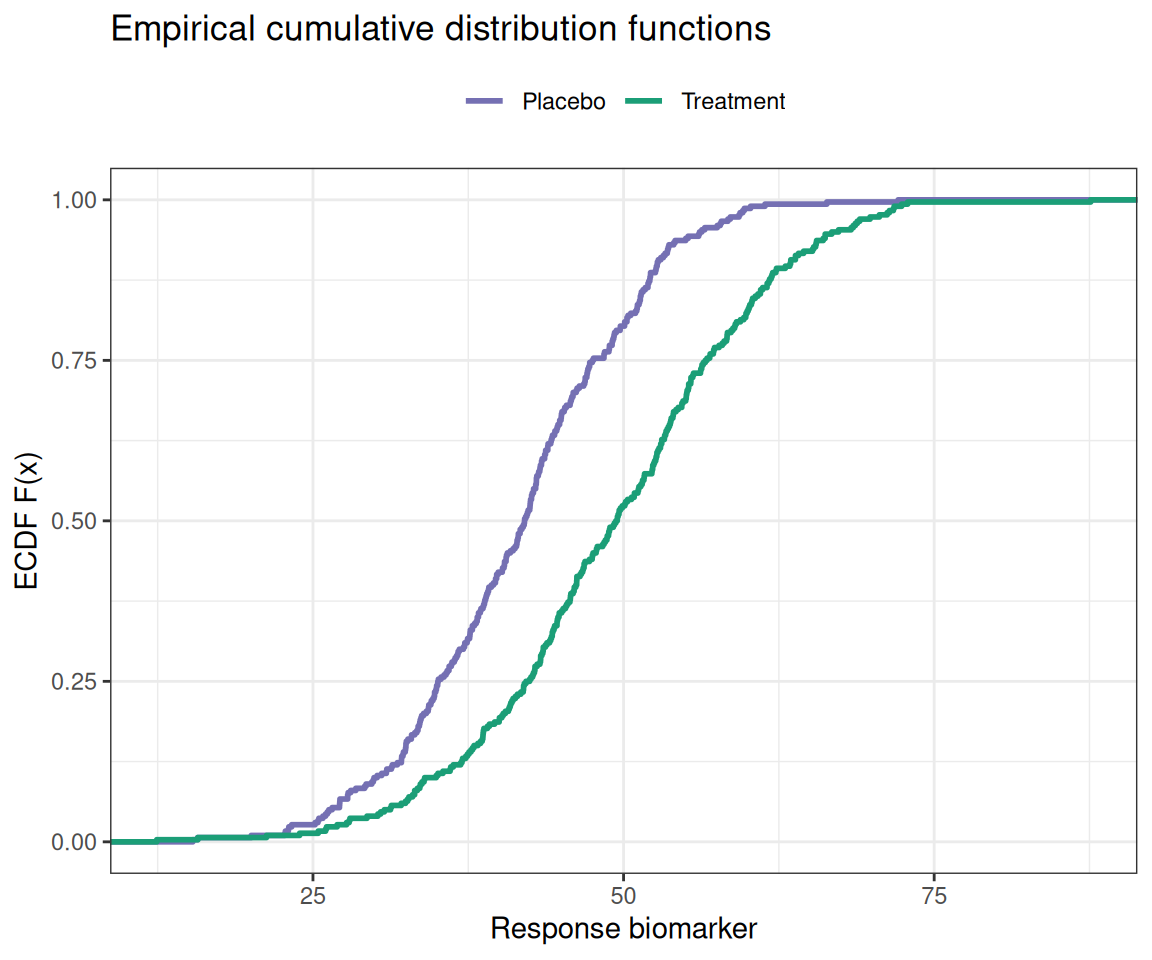
曲线整体左移意味着所有分位数都更小:整个分布发生移动——这是单纯的均数差无法证明的。
2. 多组 ECDF 与中位数
med <- expr3 |>
  group_by(gene) |>
  summarise(med = median(expr))

ggplot(expr3, aes(expr, colour = gene)) +
  stat_ecdf(geom = "step", linewidth = 0.9) +
  geom_point(data = med, aes(med, 0.5), shape = 8, size = 2.6,
             inherit.aes = FALSE, colour = "black") +
  scale_color_brewer(palette = "Dark2", name = NULL) +
  labs(x = "Expression (log2 TPM)", y = "ECDF",
       title = "Stars mark group medians (F(x) = 0.5)") +
  theme_bw(base_size = 11) +
  theme(legend.position = "top")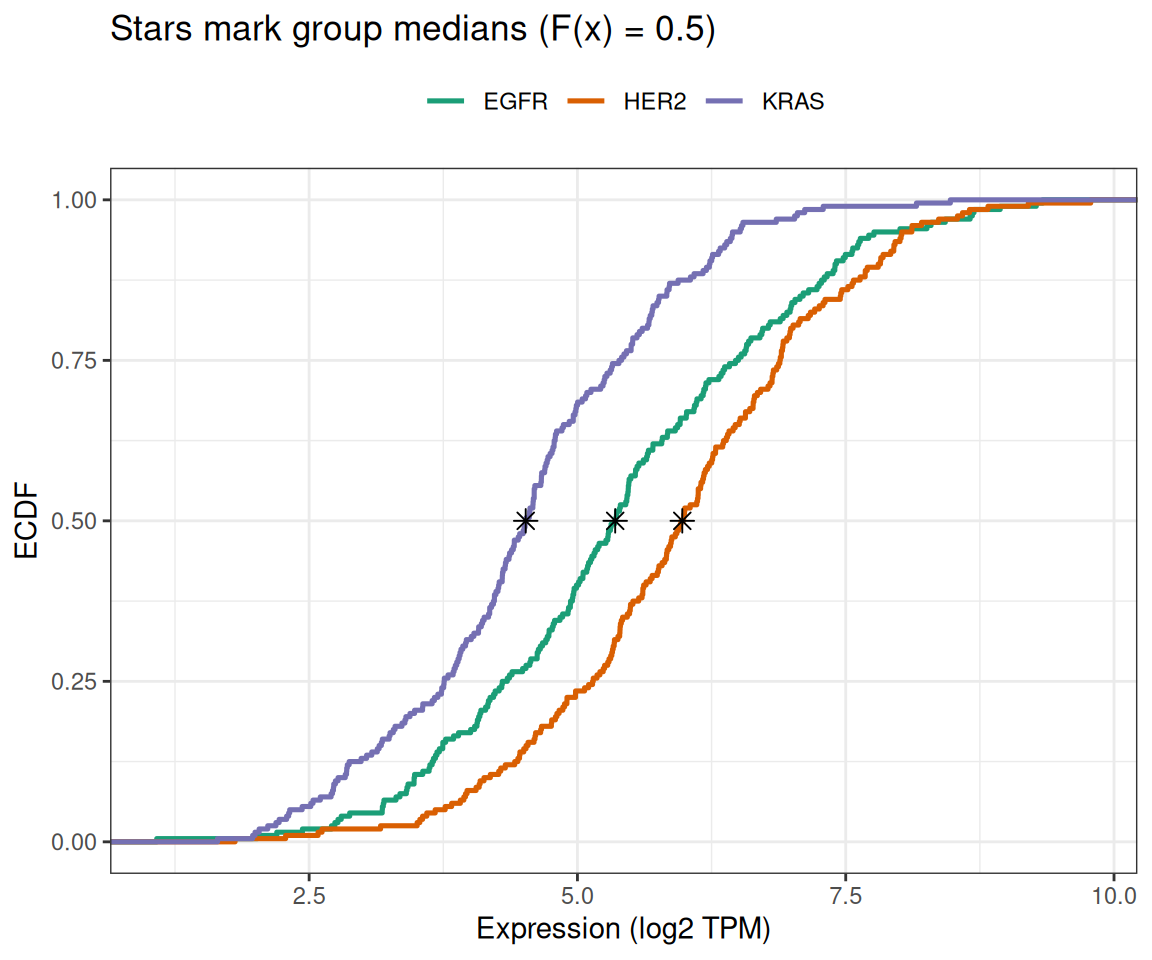
3. ECDF 差值图(KS 统计量)
ks <- ks.test(resp$value[resp$group == "Treatment"],
              resp$value[resp$group == "Placebo"])
e1 <- ecdf(resp$value[resp$group == "Treatment"])
e2 <- ecdf(resp$value[resp$group == "Placebo"])
grid <- seq(min(resp$value), max(resp$value), length.out = 600)
dd <- data.frame(x = grid, d = e1(grid) - e2(grid))
imax <- which.max(abs(dd$d))

ggplot(dd, aes(x, d)) +
  geom_line(color = "#1B7837", linewidth = 1) +
  geom_hline(yintercept = 0, linetype = "dashed", color = "grey45") +
  geom_point(data = dd[imax, ], aes(x, d), color = "#B2182B", size = 2.6) +
  annotate("text", x = dd$x[imax], y = max(abs(dd$d)), vjust = -0.8,
           size = 3.4, color = "#B2182B",
           label = sprintf("D = %.2f, KS p = %.2g", max(abs(dd$d)), ks$p.value)) +
  labs(x = "Response biomarker", y = "ECDF(Treatment) - ECDF(Placebo)",
       title = "Two-sample ECDF difference (Kolmogorov-Smirnov)") +
  theme_bw(base_size = 11)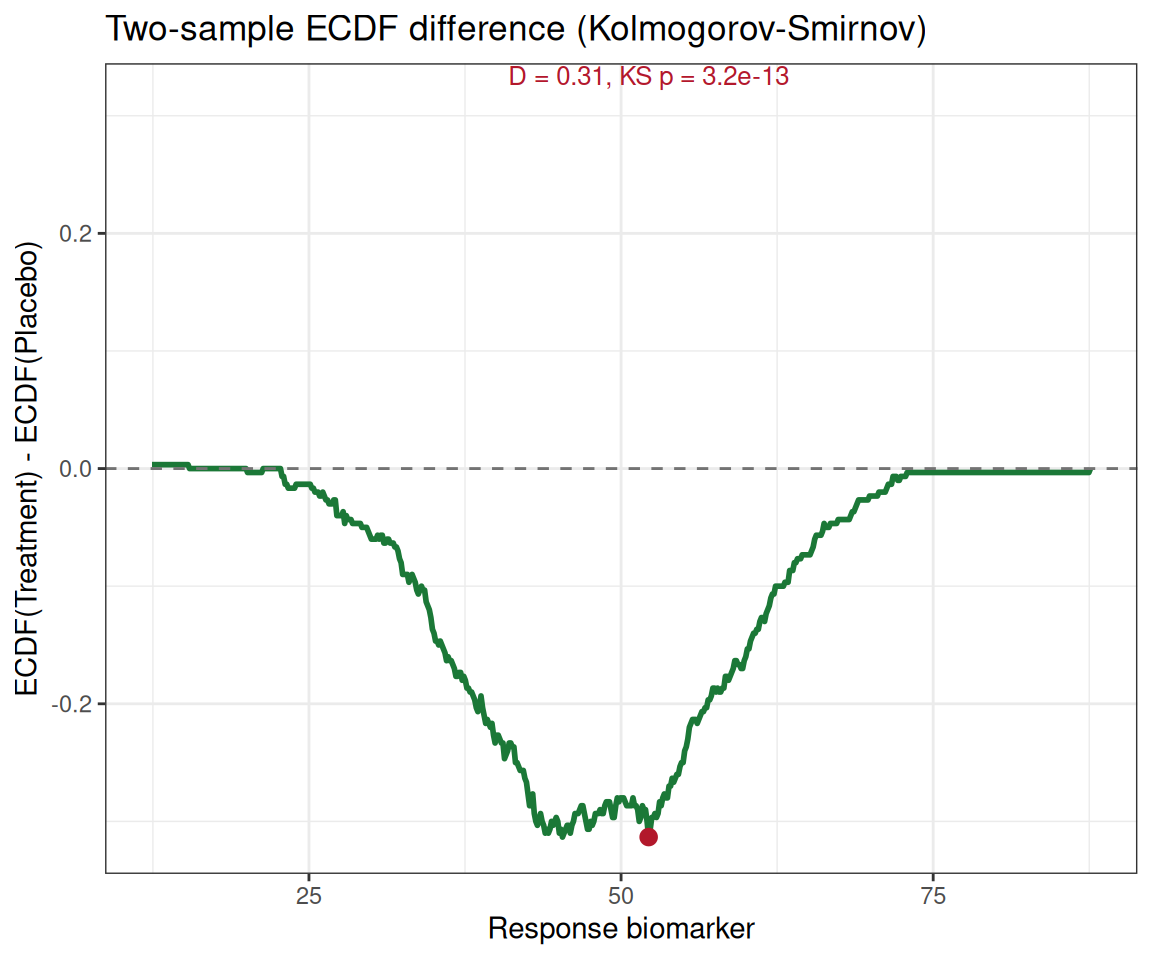
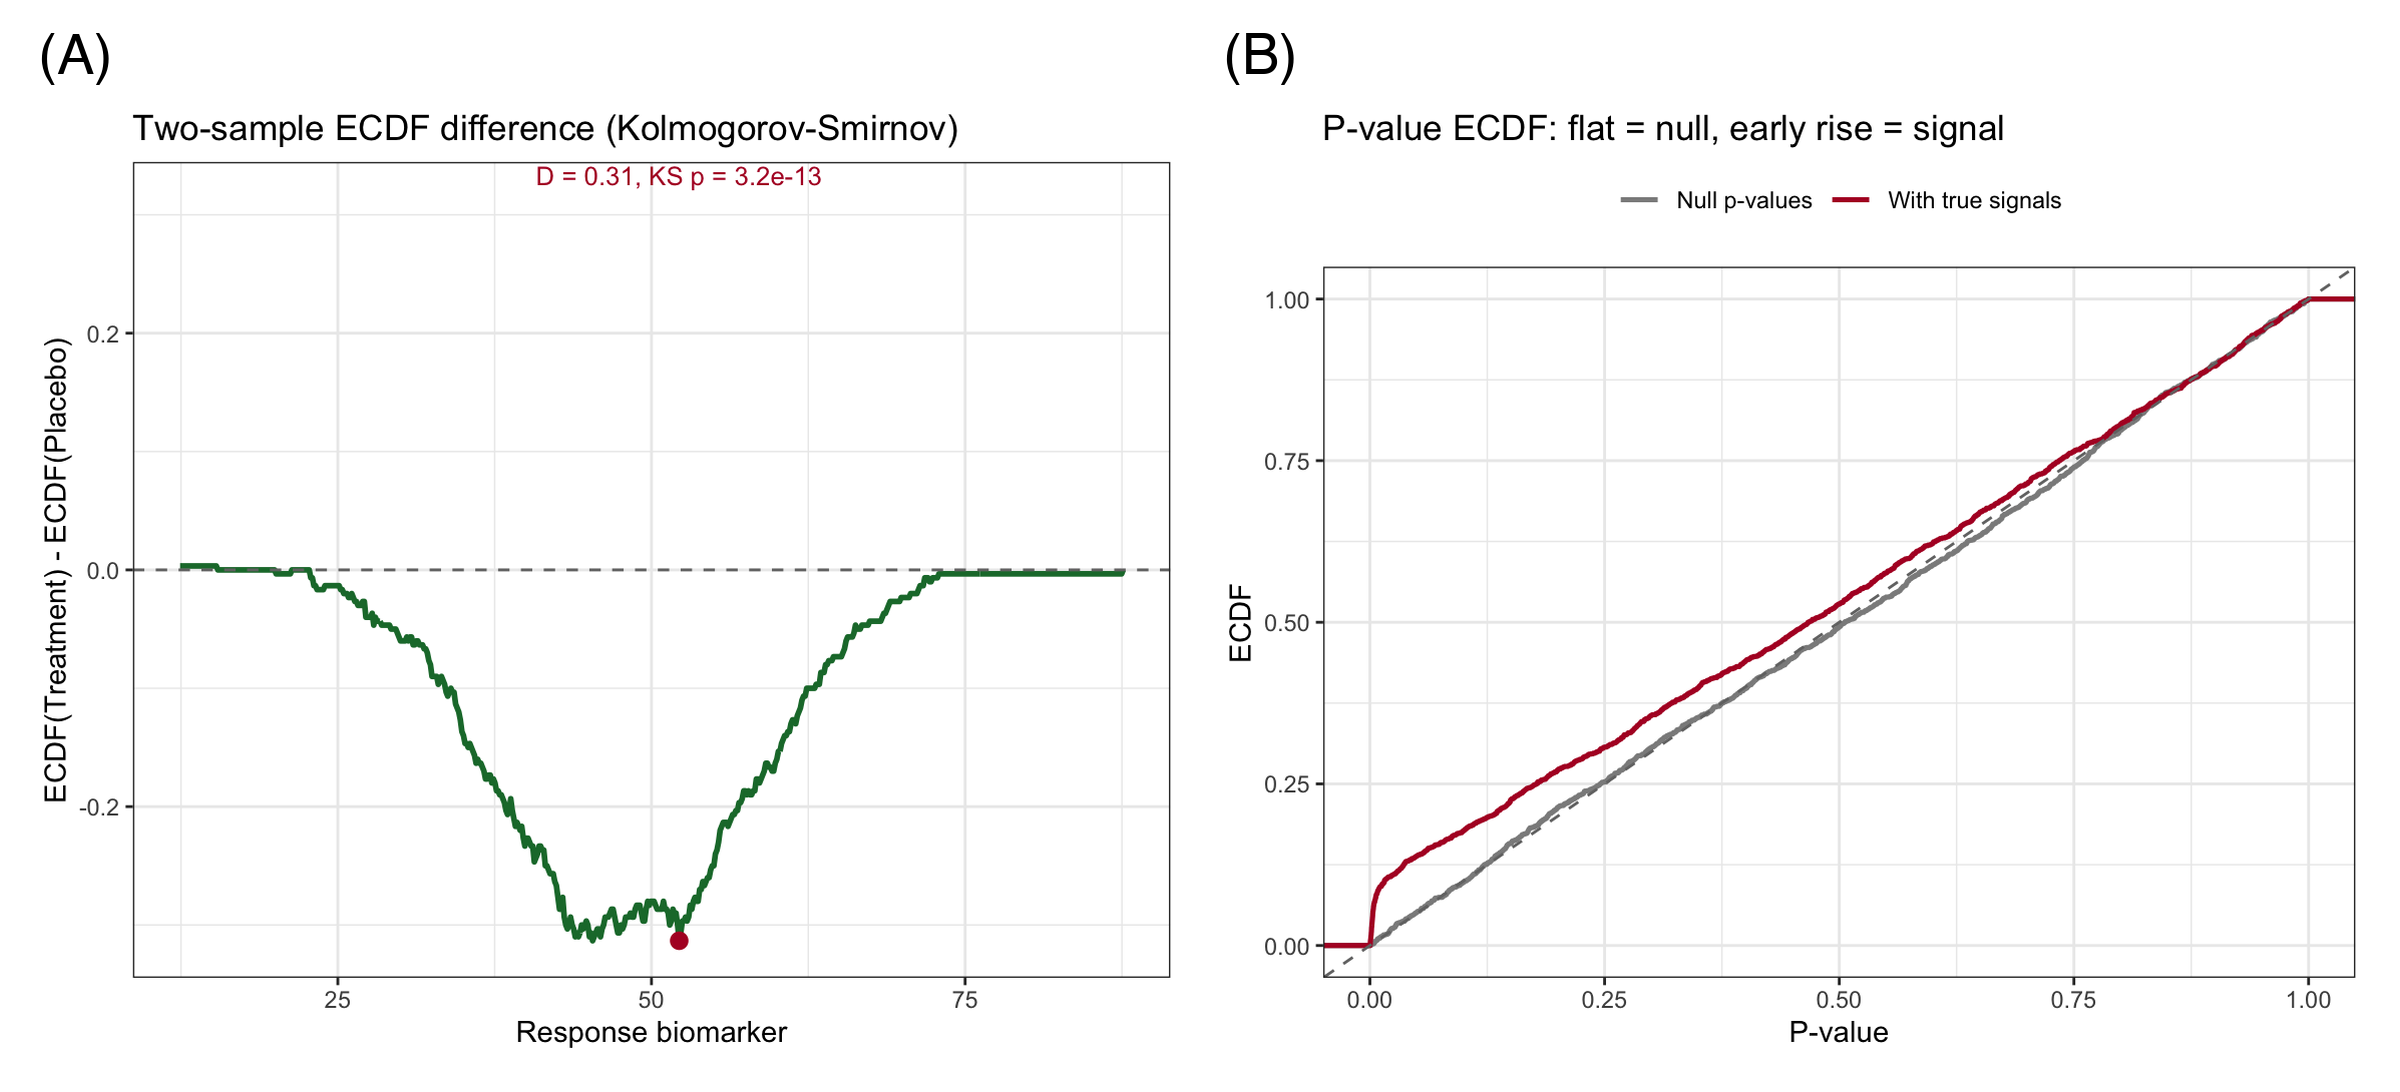
这张图显示分布在哪里不同,而不只是是否不同——本例中间距在范围中部最大,在尾部收缩。
4. p 值 ECDF(组学质控视图)
零假设为真时 p 值服从 Uniform(0,1),其 ECDF 贴合对角线。真实信号把小 p 值注入总体,使 ECDF 提前上升——这让它成为任何大规模检验流程的一眼式校准检查。
ggplot(pvdf, aes(p, colour = what)) +
  stat_ecdf(geom = "step", linewidth = 0.9) +
  geom_abline(intercept = 0, slope = 1, linetype = "dashed", color = "grey45") +
  scale_color_manual(values = c("Null p-values" = "grey55",
                                "With true signals" = "#B2182B"), name = NULL) +
  labs(x = "P-value", y = "ECDF",
       title = "P-value ECDF: flat = null, early rise = signal") +
  theme_bw(base_size = 11) +
  theme(legend.position = "top")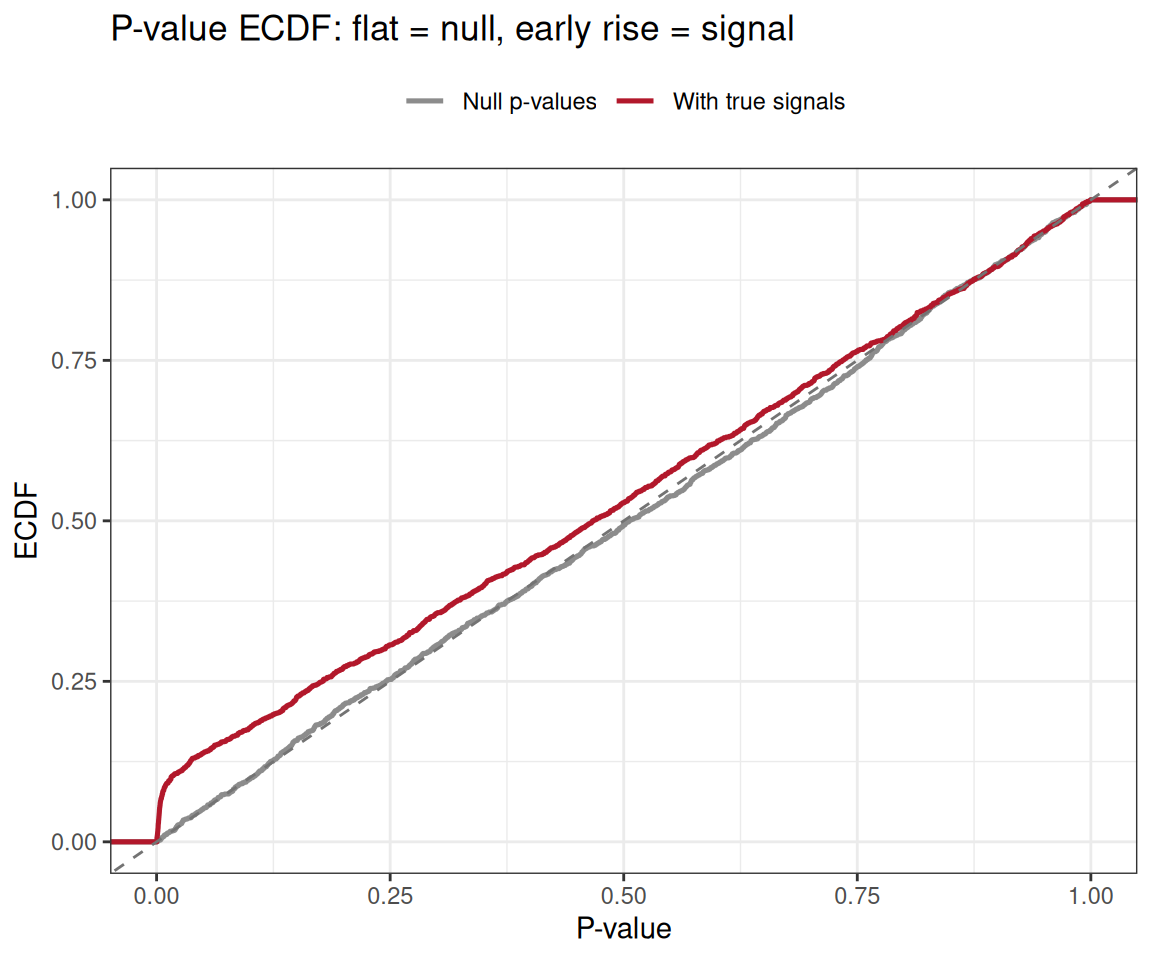
提示实践要点
- ECDF 会暴露样本量:阶梯数就是 n——若不便公开 n 请勿发表。
- 从 y 轴读分位数:F(x) = 0.25 / 0.5 / 0.75 的交点即四分位数——面向临床读者时请标注。
- 右偏数据在对数 x 轴上画 ECDF(
scale_x_log10())——单调形状经变换保持,可读性不会。 - “互补”视角:在对数 y 轴上画 1 − F(x) 以暴露上尾行为(生存曲线式)。
Application
ECDF 图适用于中位数与尾部比均数更重要的分布比较场景:药物反应筛选(每板 EC50 平移)、流式细胞标志物偏移、差异表达 p 值质控、卫生服务研究中的等待时间数据。下图模拟典型论文版式:(A) 带中位数的两组 ECDF 与 (B) KS 差值图。
Reference
[1] Chambers JM, Cleveland WS, Kleiner B, Tukey PA. Graphical Methods for Data Analysis. Belmont: Wadsworth; 1983.
[2] Hodges JL. The significance probability of the Smirnov two-sample test. Ark Mat. 1957;3(5):469-486. doi:10.1007/BF02589501