# 安装必要的包
if (!requireNamespace("PRISMA2020", quietly = TRUE)) {
  install.packages("PRISMA2020")
}

# 加载包
library(PRISMA2020)PRISMA 流程图
每篇系统综述与 Meta 分析都必须报告检索、筛选、排除和最终纳入了多少文献——即 PRISMA 2020 流程图 [1]。图的主体是两列方框:通过数据库与试验注册库进行文献识别和筛选(新研究),以及可选的、来自综述旧版本的研究和通过其他方法(引文、网站、机构)识别的研究。期刊对 2020 版模板的要求日益严格;手工绘制或格式不符的流程图是综述稿件被直接拒稿的常见原因。
PRISMA2020 R 包 [2] 从计数模板生成符合 2020 版规范的流程图,支持交互式悬停提示、逐数据库明细和 Meta 分析方框。由于流程图由代码生成,计数可以程序化验证——每个阶段必须与下一阶段在算术上对账一致——这正是编辑和审稿人首先核查的性质。
本教程涵盖三种工作流:
- 带对账检查的标准新综述流程图;
- 列出具体数据库与注册库的明细版本;
- 带悬停提示、可作在线补充材料的交互版本。
Example
Setup
系统要求:跨平台(Linux/MacOS/Windows)
编程语言:R
依赖包:
PRISMA2020(经DiagrammeR渲染)
sessioninfo::session_info("attached")─ Session info ───────────────────────────────────────────────────────────────
setting value
version R version 4.6.2 (2026-10-29)
os Ubuntu 24.04.5 LTS
system x86_64, linux-gnu
ui X11
language (EN)
collate C.UTF-8
ctype C.UTF-8
tz UTC
date 2026-10-30
pandoc 3.1.3 @ /usr/bin/ (via rmarkdown)
quarto 1.10.19 @ /usr/local/bin/quarto
─ Packages ───────────────────────────────────────────────────────────────────
package * version date (UTC) lib source
PRISMA2020 * 1.1.5 2026-09-05 [1] RSPM
[1] /home/runner/.cache/R/renv/library/Bizard-5140bdc6/linux-ubuntu-noble/R-4.6/x86_64-pc-linux-gnu
[2] /home/runner/work/_temp/Library
[3] /opt/R/4.6.2/lib/R/library
* ── Packages attached to the search path.
──────────────────────────────────────────────────────────────────────────────Data Preparation
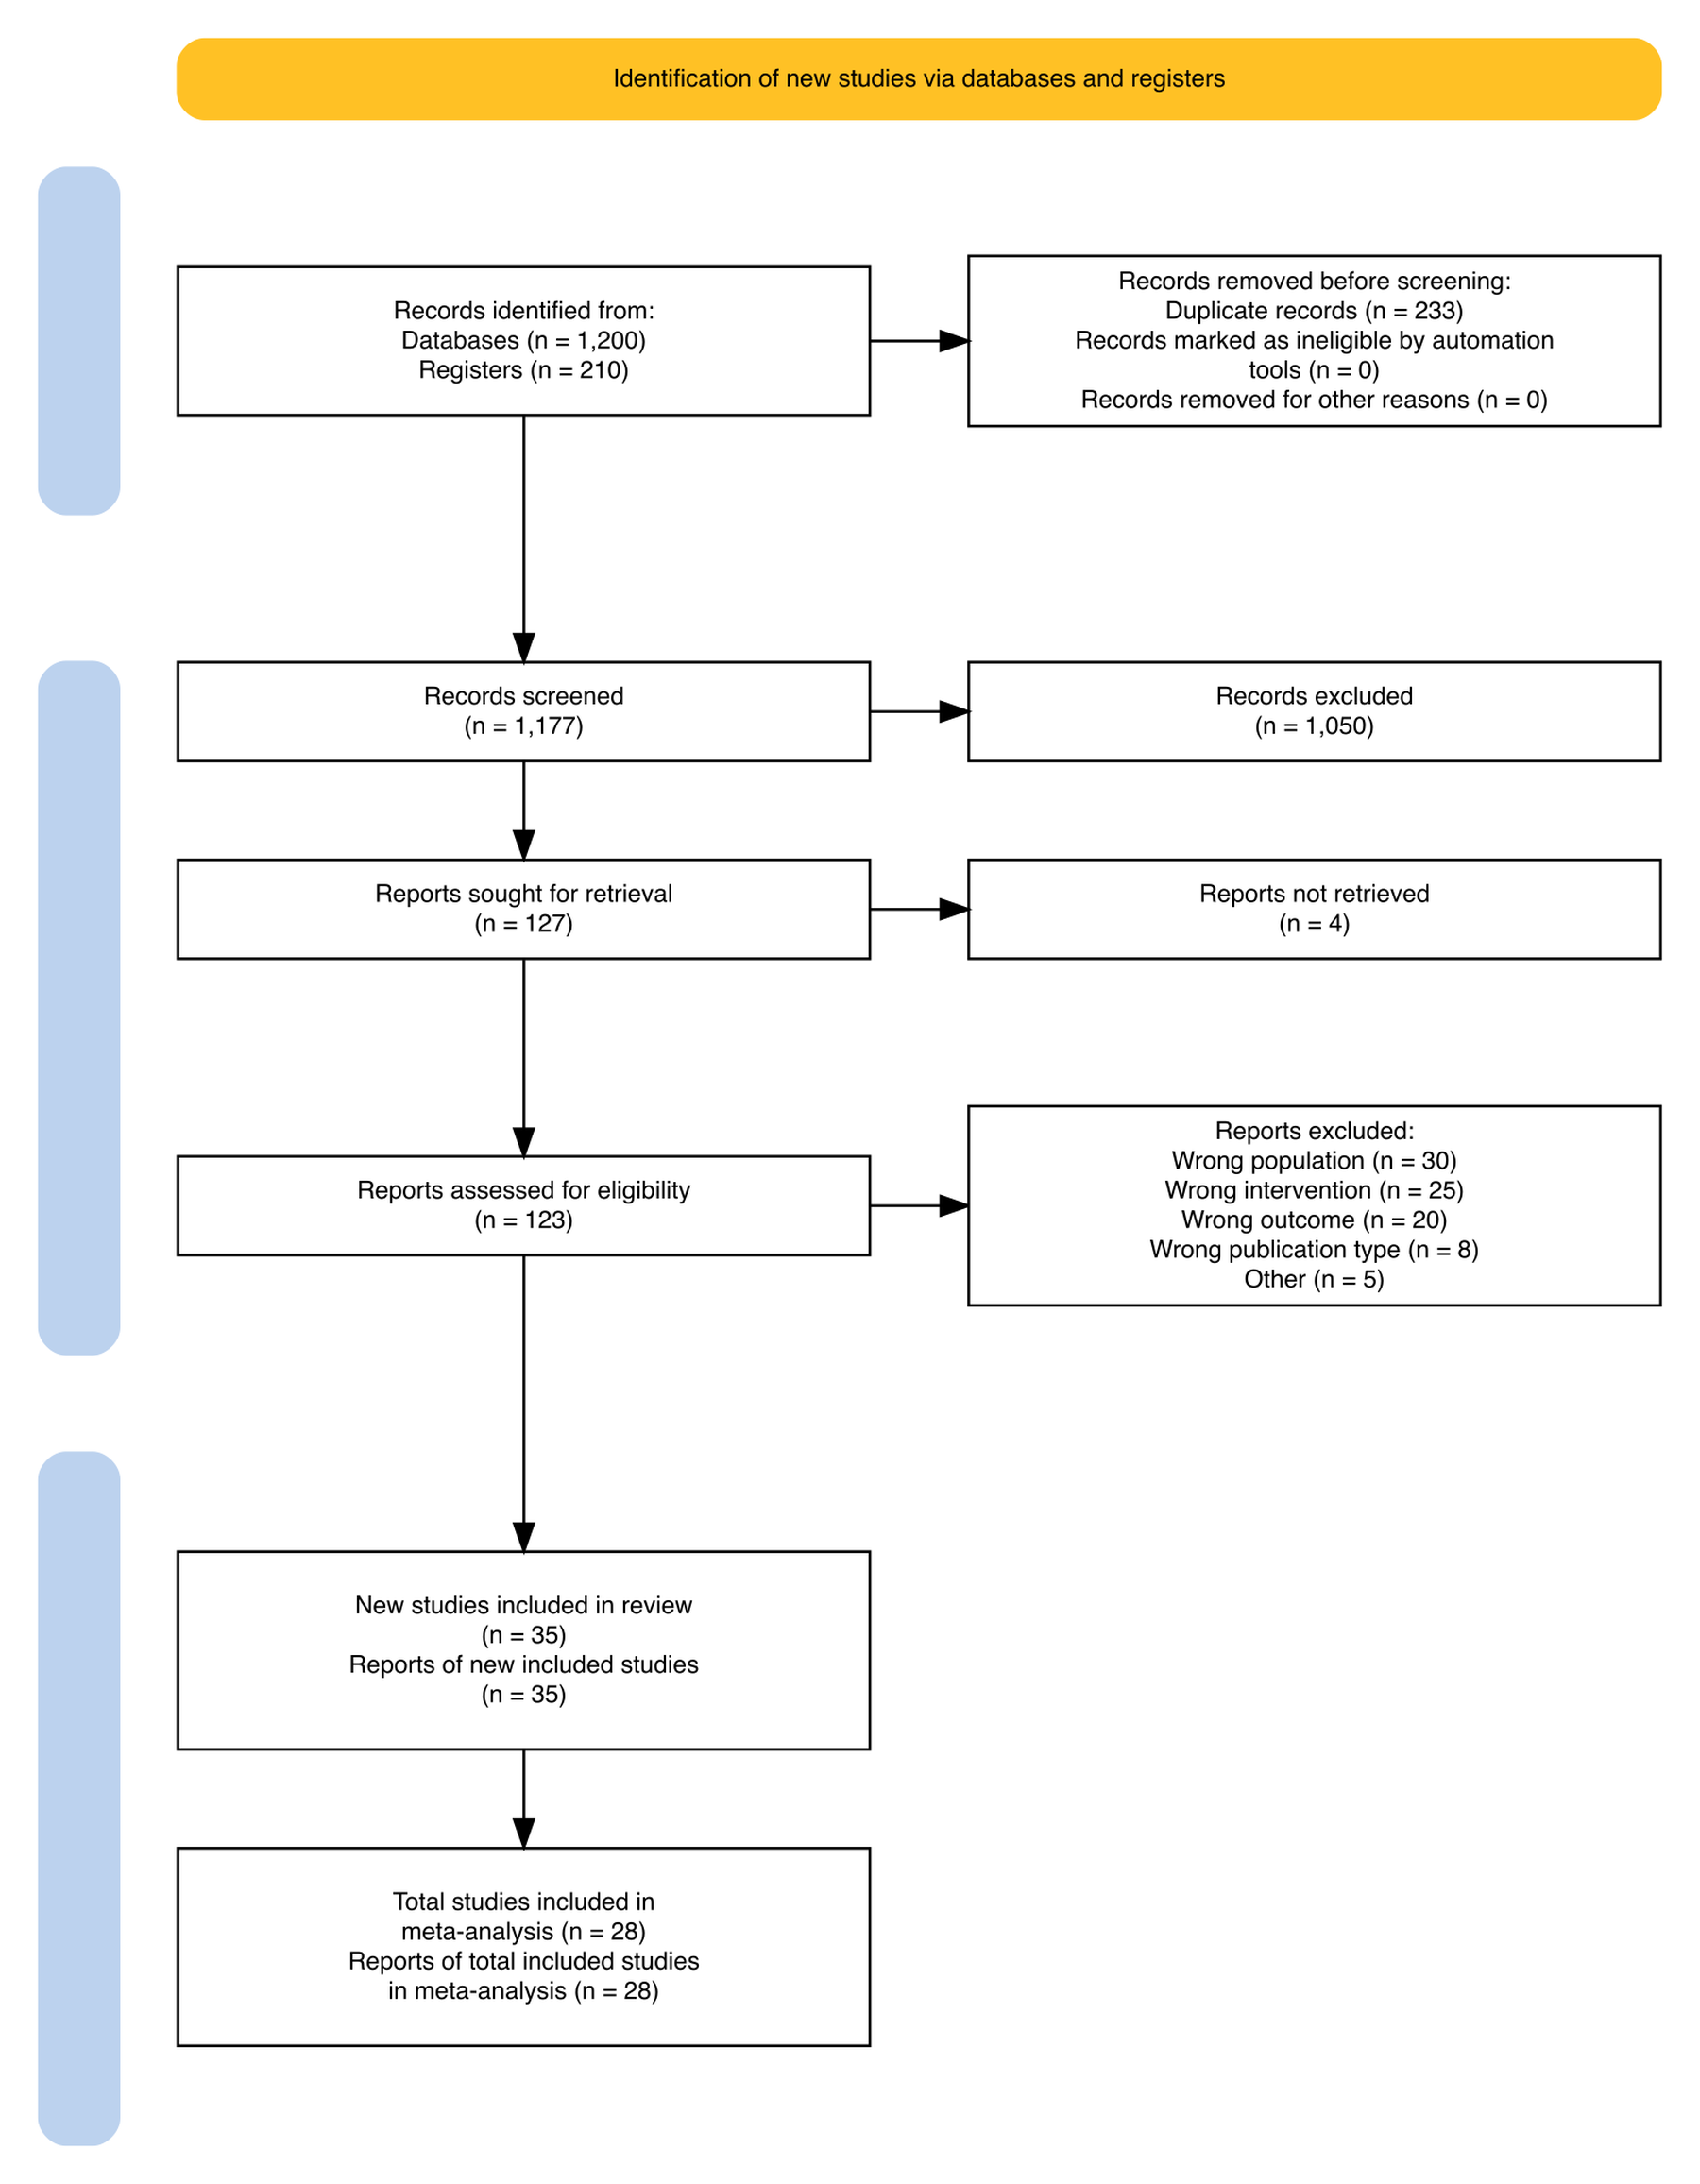
包自带 CSV 模板,每行对应图中一个方框。我们读取模板,覆盖一篇示例肿瘤学综述的计数,并清空提示 URL(仅交互模式使用)。示例流程:数据库 1,200 条 + 注册库 210 条记录,去重 233 条,筛 1,177 条,题目/摘要排除 1,050 条,寻找全文 127 篇,未获取 4 篇,评估 123 篇,附理由排除 88 篇,最终纳入 35 项研究,其中 28 项进入 Meta 分析。
tpl <- read.csv(system.file("extdata", "PRISMA.csv", package = "PRISMA2020"),
                stringsAsFactors = FALSE)

counts <- c(
  previous_studies = 0, previous_reports = 0,
  database_results = 1200, database_specific_results = 0,
  register_results = 210, register_specific_results = 0,
  website_results = 0, organisation_results = 0, citations_results = 0,
  duplicates = 233,
  excluded_automatic = 0, excluded_other = 0,
  records_screened = 1177, records_excluded = 1050,
  dbr_sought_reports = 127, dbr_notretrieved_reports = 4,
  other_sought_reports = 0, other_notretrieved_reports = 0,
  dbr_assessed = 123, dbr_excluded = 88,  # reasons enumerated below
  other_assessed = 0, other_excluded = 0,
  new_studies = 35, new_reports = 35,
  total_studies = 35, total_reports = 35,
  total_studies_ma = 28, total_reports_ma = 28
)
for (k in names(counts)) {
  idx <- which(tpl$data == k)
  if (length(idx)) tpl$n[idx] <- as.character(counts[[k]])
}
# 全文排除必须逐条列出理由(PRISMA 2020);格式 "理由, 条数; …",合计等于 dbr_excluded
tpl$n[tpl$data == "dbr_excluded"] <-
  "研究人群不符, 30; 干预措施不符, 25; 结局指标不符, 20; 出版类型不符, 8; 其他, 5"
tpl$url[!is.na(tpl$url)] <- ""   # 提示超链接:仅交互模式使用

prisma_counts <- PRISMA_data(tpl)
绘图前先验证数字对账——PRISMA 审稿意见中最常见的批评就是方框数字加不上 [1]:
# 对账基于原始计数(PRISMA_data() 会把数字渲染为显示格式,如 "1,177",
# 因此算术应在原始 counts 上进行)
stopifnot(
  counts[["database_results"]] + counts[["register_results"]] - counts[["duplicates"]] == counts[["records_screened"]],
  counts[["records_screened"]] - counts[["records_excluded"]] == counts[["dbr_sought_reports"]],
  counts[["dbr_sought_reports"]] - counts[["dbr_notretrieved_reports"]] == counts[["dbr_assessed"]],
  counts[["dbr_assessed"]] - counts[["dbr_excluded"]] == counts[["new_studies"]]
)
cat("各阶段对账通过:1,200 + 210 - 233 = 1,177 筛选;",
    "123 篇评估;35 项纳入;28 项进 Meta 分析。\n")
各阶段对账通过:1,200 + 210 - 233 = 1,177 筛选; 123 篇评估;35 项纳入;28 项进 Meta 分析。Visualization
1. 标准新综述流程图
p1 <- PRISMA_flowdiagram(prisma_counts,
                         interactive = FALSE,
                         previous = FALSE, other = FALSE,
                         meta_analysis = TRUE,
                         side_boxes = TRUE,
                         fontsize = 9)
p1两个蓝色侧框标注综述阶段(identification、screening、included);若 previous = TRUE,金黄色的标题框会标注综述的旧版本。计数打印在每个方框内,被去除的记录向右分支展示。
2. 明细版本:逐数据库分解
试验报告和综述指南常要求说明记录来自哪里。填好 database_specific_results / register_specific_results 行并打开明细开关后重新绘图,即可列出每个检索来源:
tpl_d <- tpl
# 逐来源明细写入 *_specific_results 行的 n 列,格式 "来源, 条数; …"
tpl_d$n[tpl_d$data == "database_specific_results"] <- "PubMed, 520; Embase, 400; Web of Science, 280"
tpl_d$n[tpl_d$data == "register_specific_results"] <- "Cochrane Register, 120; ClinicalTrials.gov, 90"
prisma_detailed <- PRISMA_data(tpl_d)

p2 <- PRISMA_flowdiagram(prisma_detailed,
                         interactive = FALSE,
                         previous = FALSE, other = FALSE,
                         detail_databases = TRUE,
                         detail_registers = TRUE,
                         meta_analysis = FALSE,
                         side_boxes = TRUE,
                         fontsize = 9)
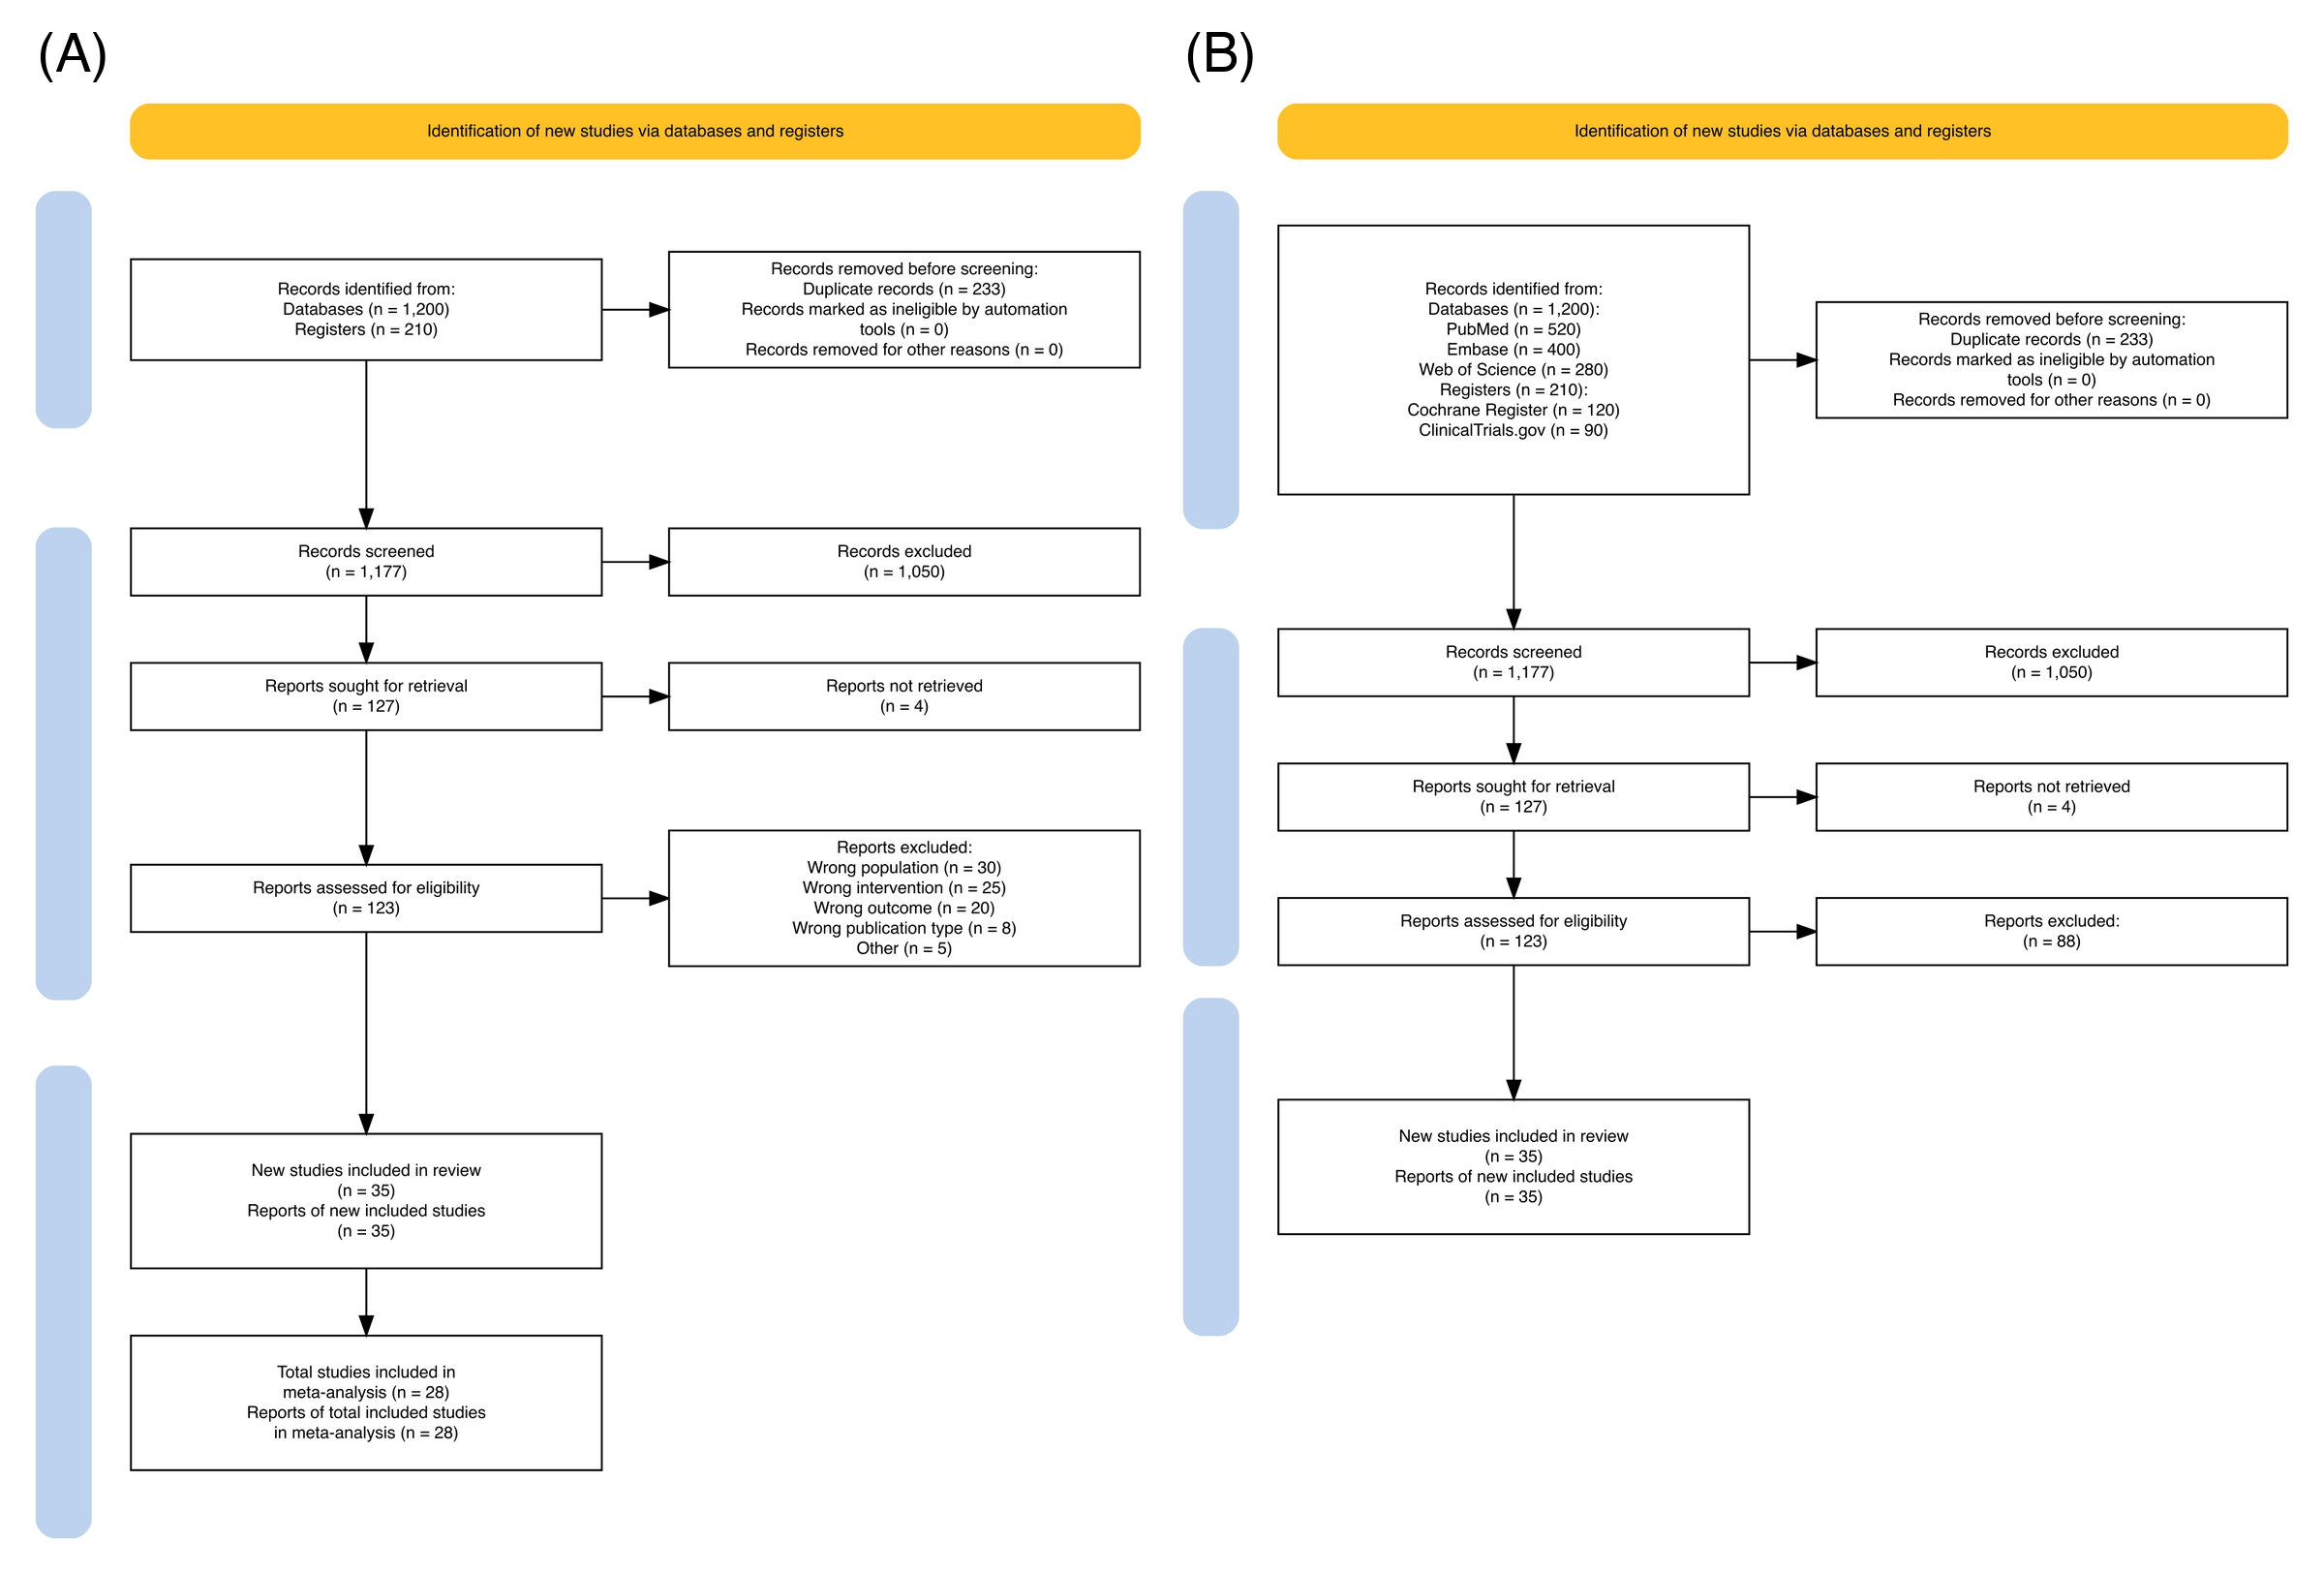
p2逐来源条目继承上面的 来源, 条数 对——替换成你的综述实际检索的来源即可,保持相同的 来源, 条数; … 格式。
3. 带悬停提示的交互版本
p3 <- PRISMA_flowdiagram(prisma_counts,
                         interactive = TRUE,
                         previous = FALSE, other = FALSE,
                         meta_analysis = TRUE,
                         side_boxes = TRUE,
                         fontsize = 9)
p3在渲染出的 HTML 页面中,方框会对鼠标悬停作出响应,使在线补充材料中的流程图自带说明;同一流程图导出为 PDF 后仍是完全静态的。
提示实践要点
- 投稿前程序化对账(见 Data Preparation):检索 − 去重 = 筛选;筛选 − 排除 = 找全文;评估 − 排除 = 纳入。
- 排除全文必须附理由——若排除理由多于几类,2020 版声明要求逐一列举(模板的
dbr_excluded行)。 - 仅在更新版综述中设
previous = TRUE;误用会生成与 2020 模板不符的图。
Application
PRISMA 流程图出现在每篇系统综述稿件、注册方案(PROSPERO 更新)以及随时间刷新检索的 living review 中。下图模拟典型论文版式:(A) 标准新综述流程图,(B) 逐数据库明细版本。
Reference
[1] Page MJ, McKenzie JE, Bossuyt PM, et al. The PRISMA 2020 statement: an updated guideline for reporting systematic reviews. BMJ. 2021;372:n71. doi:10.1136/bmj.n71
[2] Haddaway NR, Page MJ, Pritchard CC, McGuinness LA. PRISMA2020: An R package and Shiny app for producing PRISMA 2020-compliant flow diagrams, with interactivity for optimised digital transparency and Open Synthesis. Campbell Syst Rev. 2022;18(2):e1230. doi:10.1002/cl2.1230