import matplotlib.pyplot as plt
import pandas as pd
import numpy as npMA 图(Python)
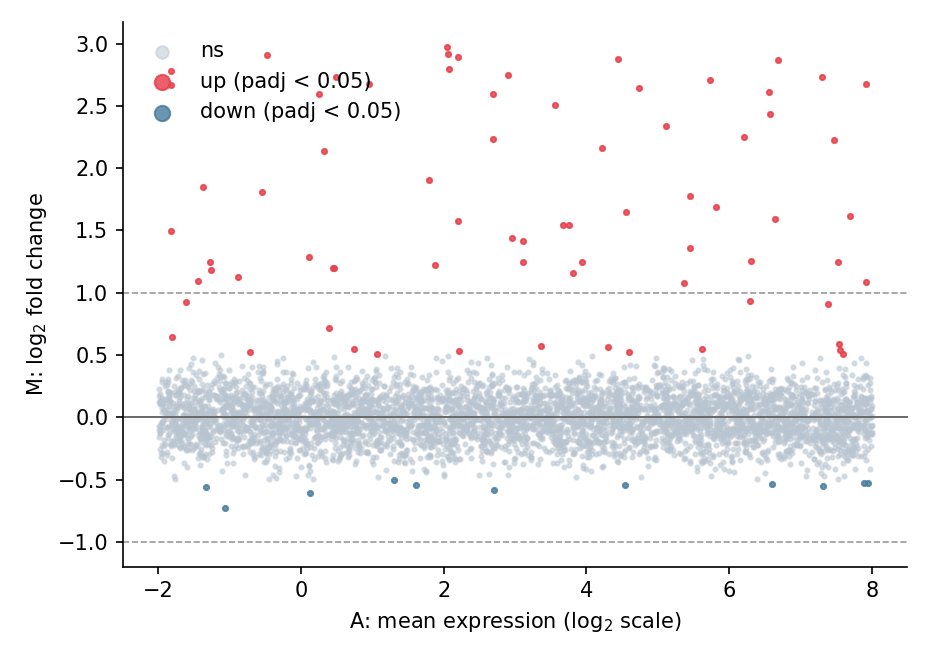
MA 图把每个特征放在平均表达量(A = log 计数均值)与 log2 倍数变化(M)的坐标中,揭示差异检验中随表达强度变化的偏倚:结果良好的对比应散布在 M = 0 附近,真实信号则抬离基线。审阅差异分析表时,它与火山图互为补充。图形就是任意差异表之上的几层 matplotlib 图元。
示例
环境配置
- 系统要求:跨平台(Linux/MacOS/Windows)
- 编程语言:Python
- 依赖包:
matplotlib、pandas、numpy
数据准备
我们模拟 5,000 个基因的差异表达表:基础表达范围、围绕 log2 倍数变化的对称小噪声,以及注入的 60 个上调基因(不同表达强度下的正 log2FC);显著性集中于高倍数变化基因。
np.random.seed(121)

n = 5000
de = pd.DataFrame({
    'baseMean_log': np.random.uniform(-2, 8, n),
})
de['log2FC'] = np.random.normal(0, 0.18, n)
de.loc[de.index[:60], 'log2FC'] = np.random.uniform(0.9, 3.0, 60)
de['padj'] = np.clip(
    10 ** (-np.abs(de.log2FC) * 9 - np.random.exponential(1.0, n)), 0, 1)
de.loc[de.log2FC.abs() < 0.5, 'padj'] = np.maximum(
    de.loc[de.log2FC.abs() < 0.5, 'padj'], 0.05)
de['sig'] = de.padj < 0.05
可视化
基础 MA 图
对称化坐标压缩 A 轴范围;M = 0 与 |log2FC| = 1 参考线为视线提供标定。
fig, ax = plt.subplots(figsize=(6.2, 4.4))
ax.scatter(de.loc[~de.sig, 'baseMean_log'], de.loc[~de.sig, 'log2FC'],
           s=4, color='#b8c4d0', alpha=0.5, label='ns', rasterized=True)
sig = de.sig & (de.log2FC > 0)
ax.scatter(de.loc[sig, 'baseMean_log'], de.loc[sig, 'log2FC'],
           s=6, color='#e63946', alpha=0.8, label='up (padj < 0.05)',
           rasterized=True)
sig_dn = de.sig & (de.log2FC < 0)
ax.scatter(de.loc[sig_dn, 'baseMean_log'], de.loc[sig_dn, 'log2FC'],
           s=6, color='#457b9d', alpha=0.8, label='down (padj < 0.05)',
           rasterized=True)
ax.axhline(0, color='0.4', linewidth=0.9)
for fc in (1, -1):
    ax.axhline(fc, color='0.6', linewidth=0.8, linestyle='--')
ax.set_xlabel('A: mean expression (log$_{2}$ scale)')
ax.set_ylabel('M: log$_{2}$ fold change')
ax.legend(frameon=False, markerscale=3, loc='upper left')
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()
标注头部基因的 MA 图
标注最强的命中基因,使图形兼作结果摘要;错开的偏移量防止标签相互碰撞。
top = de.nlargest(6, 'log2FC')

fig, ax = plt.subplots(figsize=(6.2, 4.4))
ax.scatter(de.baseMean_log, de.log2FC, s=4,
           color=np.where(de.sig, '#e63946', '#b8c4d0'),
           alpha=0.55, rasterized=True)
ax.axhline(0, color='0.4', linewidth=0.9)
for i, (_, row) in enumerate(top.iterrows()):
    ax.annotate(f'GENE{i+1}', xy=(row.baseMean_log, row.log2FC),
                xytext=(row.baseMean_log - 1.2, row.log2FC + 0.25 + 0.18 * (i % 3)),
                fontsize=8.5, color='0.15',
                arrowprops=dict(arrowstyle='-', color='0.5', lw=0.7))
ax.set_xlabel('A: mean expression (log$_{2}$ scale)')
ax.set_ylabel('M: log$_{2}$ fold change')
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()
plt.show()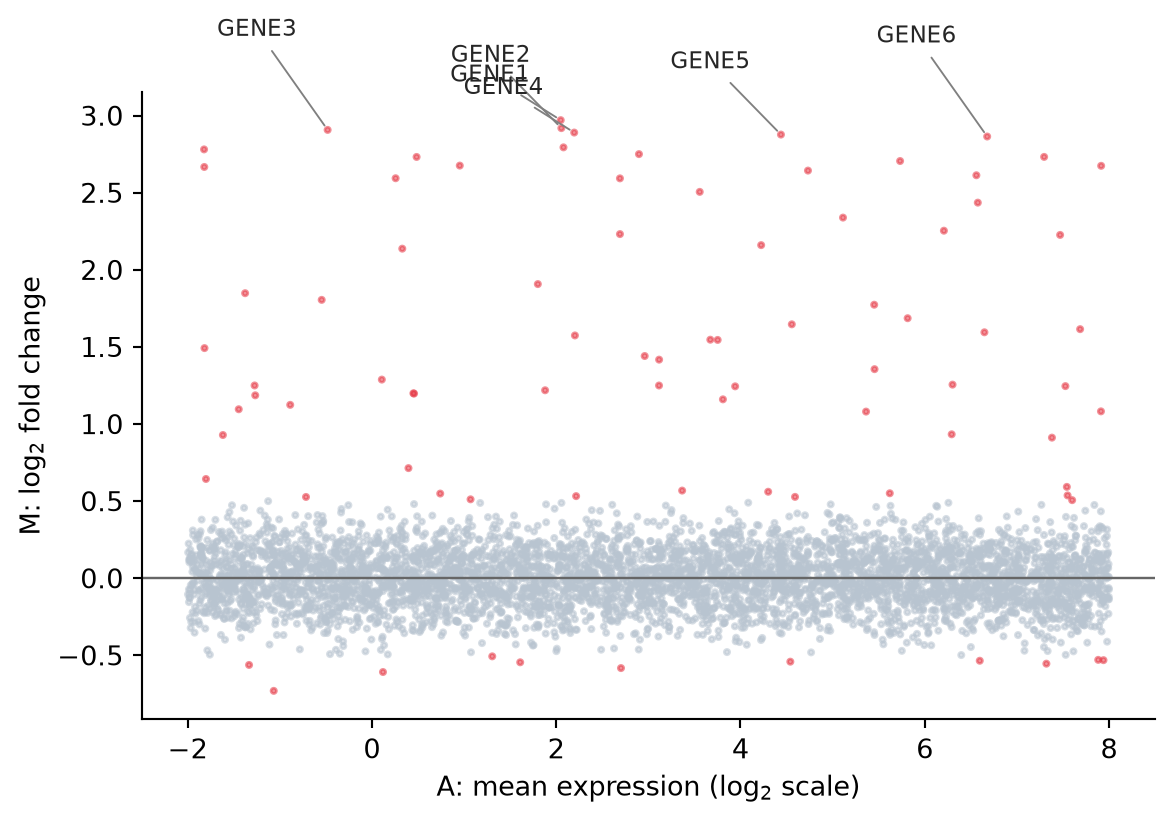
参考文献
- Ritchie, M. E., et al. (2015). limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Research, 43(7), e47.
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90-95.